Welches Text-zu-Video-Modell passt zu dir?
Alle vier Modelle erstellen aus einem geschriebenen Prompt Videos mit Ton, verhalten sich aber unterschiedlich. Die folgenden Hinweise stammen aus unabhängigen Tests mit identischen Prompts von Fuser, Krea und Atlas Cloud, aus den Prompt-Guides der Hersteller und aus den Beispielen, die wir selbst generiert haben. Platzierungen und Preise stehen in der Tabelle oben.
Wan 3.0, das KI-Videomodell von Alibaba, setzt den Prompt am wörtlichsten um. In Kreas Test lieferte es „the most literal, dramatic version of a prompt“, und in Fusers fünf Runden mit identischem Input erfasste es Details, die Seedance 2.5 übersah. Es erstellt bis zu 30 Sekunden in einem Durchgang und kostet pro Sekunde weniger als Seedance 2.5. Seine Schwächen: Manchmal wechselt es mitten im Video die Perspektive, und der Ton ist laut abgemischt (Krea, Fuser).
Seedance 2.5 vom TikTok-Mutterkonzern ByteDance wirkt von den vier Modellen am meisten wie ein Kinofilm: Licht auf Metall, Glas und Haut, ein ruhigerer Mix und Dialoge in mehr als zehn Sprachen. Pro Sekunde ist es das teuerste der vier, in Nahaufnahmen bei 720p werden Gesichter weicher, und schnelle Bewegungen können verzerren. Der Guide von ByteDance rät zu einer Kamerabewegung pro Einstellung (ByteDance).
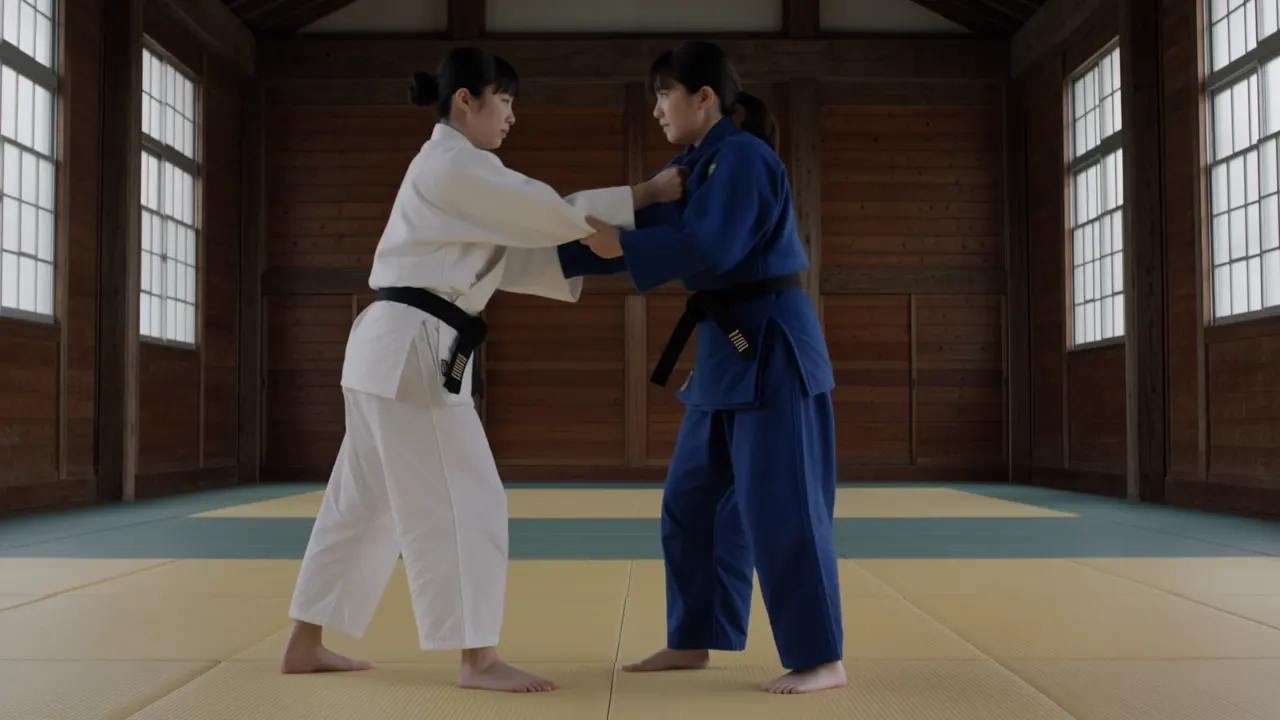
Kling 4.0 (Kling AI) vom chinesischen Kurzvideo-Anbieter Kuaishou ist das Modell für Action und lange Einstellungen: Bei allen Testern hielten Aufnahmen von 15 bis 30 Sekunden ohne Schnitt, in unserem Judowurf blieben Arme und Beine bei der richtigen Person, und Schild und Untertitel waren richtig geschrieben. Ohne gegenteilige Anweisung setzt es Schnitte und Musik, und manche Stilangaben wie einen bestimmten Filmmaterial-Look lässt es weg (Fuser).
MiniMax H3 (Hailuo AI) vom KI-Unternehmen MiniMax gibt es hier in zwei Versionen. H3 Max Turbo ist am schnellsten und kostet von allen Videos auf dieser Seite am wenigsten – gut, um Formulierungen zu testen, bevor du mehr ausgibst. Die offizielle Version H3 bietet zusätzlich 2K. 768p rendert H3 als 1344×768 statt 720p, und kurze Prompts schreibt es um, was einen Schnitt hinzufügen kann (Krea).
Text-zu-Video oder Bild-zu-Video?
Bei Text-zu-Video erfindet das Modell alles aus deinen Worten, deshalb ergeben zwei Durchläufe mit demselben Prompt zwei verschiedene Videos. Wenn Produkt, Figur oder Bildaufbau zu etwas passen müssen, das du schon hast, startest du besser mit einem Bild: Bei Bild-zu-Video ist dein Bild das Startbild. Ein üblicher Ablauf: das Standbild mit dem KI-Bildgenerator erstellen und es dann animieren.
Länge, Auflösung und Format
Wähle die kürzeste Länge, in die die Handlung passt. 5 Sekunden reichen für eine Bewegung, 10 Sekunden für zwei oder drei Abschnitte mit Zeitangaben, 20 bis 30 Sekunden eignen sich für eine lange Einstellung mit Kling 4.0 oder Wan 3.0. Die Auflösung beeinflusst den Preis stärker als alles andere, und ein neuer Durchlauf in höherer Auflösung ist eine neue Aufnahme, kein Hochskalieren deines Entwurfs – nutze 720p also nur, um Formulierungen zu testen. Lege das Seitenverhältnis vor dem Generieren fest: 16:9 im Querformat für YouTube und Websites, 9:16 im Hochformat fürs Smartphone (Reels, TikTok, Shorts), 1:1 für Feeds und 21:9 mit Kling 4.0, Seedance 2.5 und MiniMax H3 für ein breites Kinoformat.
Was du bezahlst
Jedes Video hat einen Preis in Credits, der von Modell, Länge, Auflösung und Ton abhängt, und du siehst ihn, bevor du generierst. Credits bekommst du in Credit-Paketen, die du einmalig bezahlst. Deine Credits verfallen nicht, und es gibt kein Abo, das du kündigen müsstest. Schlägt ein Video fehl, überschreitet es das Zeitlimit oder wird es abgelehnt, bekommst du die Credits automatisch zurück.
So sind die Beispiele auf dieser Seite entstanden
Zu jedem Beispiel siehst du Prompt, Modell und Einstellungen sowie den heutigen Preis auf zzo.ai. Die meisten Prompts stammen aus veröffentlichten Tests und Guides, die auf jeder Karte genannt sind – so kannst du unser Ergebnis mit ihrem vergleichen. Die Prompts sind auf Englisch, so wie das Modell sie bekommen hat. Einige Beispiele wurden in der App des Modellherstellers mit demselben Modell, Prompt und denselben Einstellungen erstellt und sind entsprechend gekennzeichnet. Kein Video ist nachbearbeitet, und wo ein Video einen Teil des Prompts verfehlt hat, steht es auf der Karte.