4 Modelle erstellen Videos von 4 bis 30 Sekunden in bis zu 2K; 4 davon mit Ton. Videos gibt es ab 25 Credits (0,25 $), ohne Abo, und deine Credits verfallen nicht. Platzierungen in der Artificial Analysis Image to Video Arena (Stand: 30. Oktober 2026): Seedance 2.5 auf Platz 1 (Elo 1.152), MiniMax H3 auf Platz 4, Wan 3.0 auf Platz 9.
Lade ein Bild hoch, beschreibe, wie es sich bewegen soll, und du bekommst ein KI-Video mit Ton, das mit deinem Bild beginnt. So machst du aus einem Foto, einem Gemälde oder einem Produktbild ein Video. Den Preis siehst du vor dem Generieren, bezahlt wird mit Credits aus einem Credit-Paket, das du einmalig kaufst, und schlägt ein Video fehl, bekommst du die Credits automatisch zurück.
Lade ein Foto hoch und beschreibe, wie es sich bewegen soll.
Startbild
Das Foto, aus dem dieses Video entstanden ist
Mit diesen Modellen erstellt
Bei jedem siehst du Prompt, Modell und was es hier kostet. Wähl eins aus, um damit zu starten.
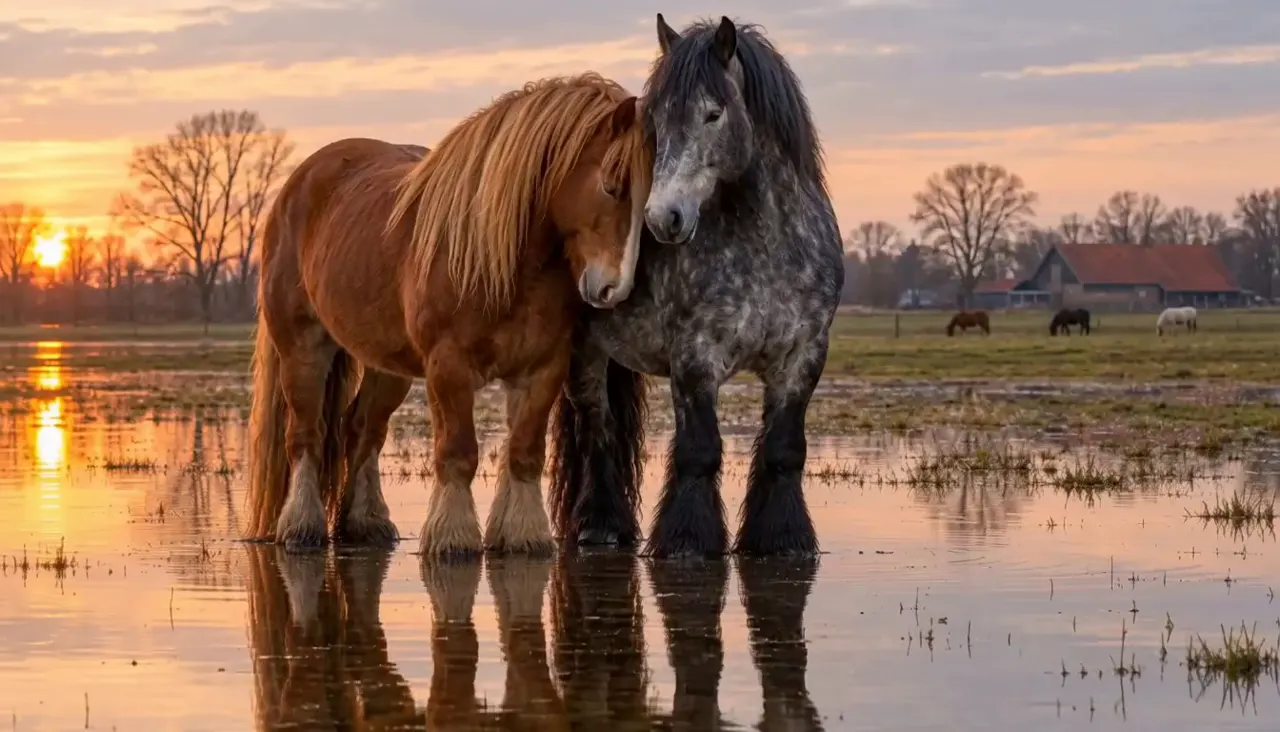
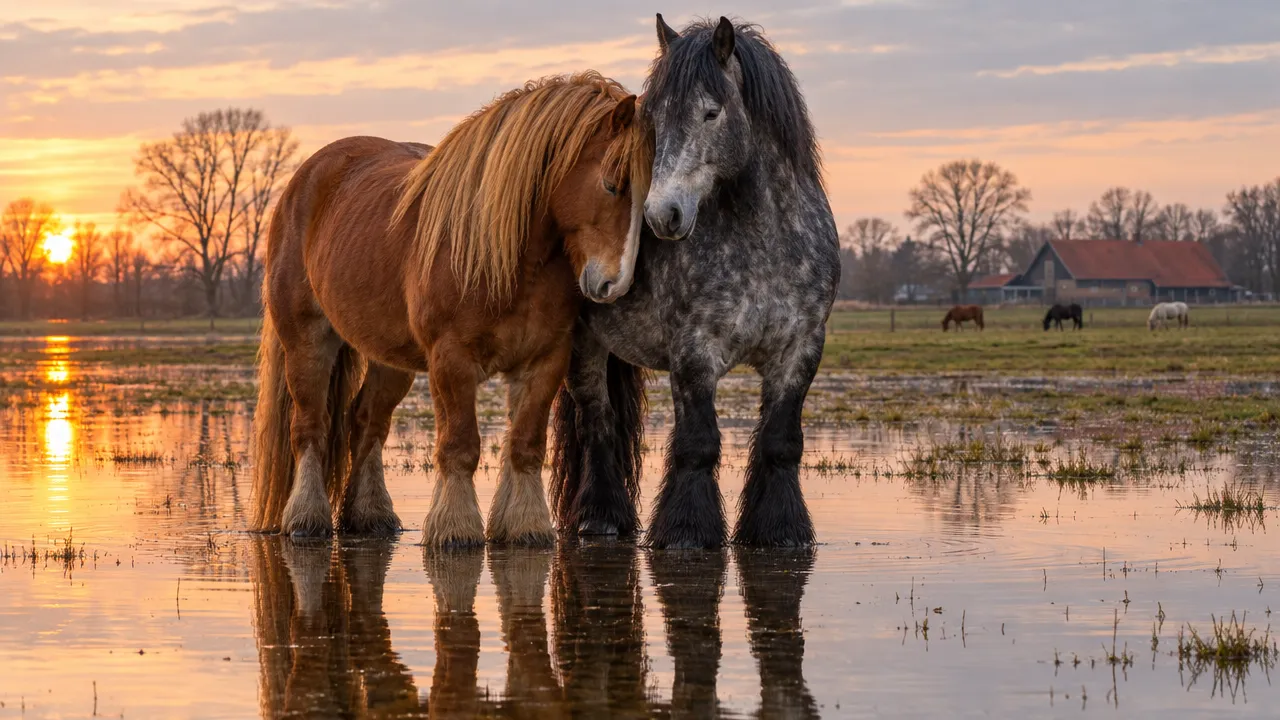
“Two heavy draft horses stand together in a shallow flooded pasture at dusk — a chestnut with a long flaxen-copper mane, head lowered and turned inward, resting against the shoulder of a dark dapple-grey with black feathered legs. Ankle-deep still water mirrors them almost perfectly. Golden-hour side light, pale peach and dove-grey sky, bare winter trees and a red-roofed barn far in the background with small grazing horses. Extremely slow, quiet motion”MiniMax H3, Bild-zu-Video, 5 s, mit Ton, 40 Credits, Eingabebild mit GPT Image 2.5 erstellt
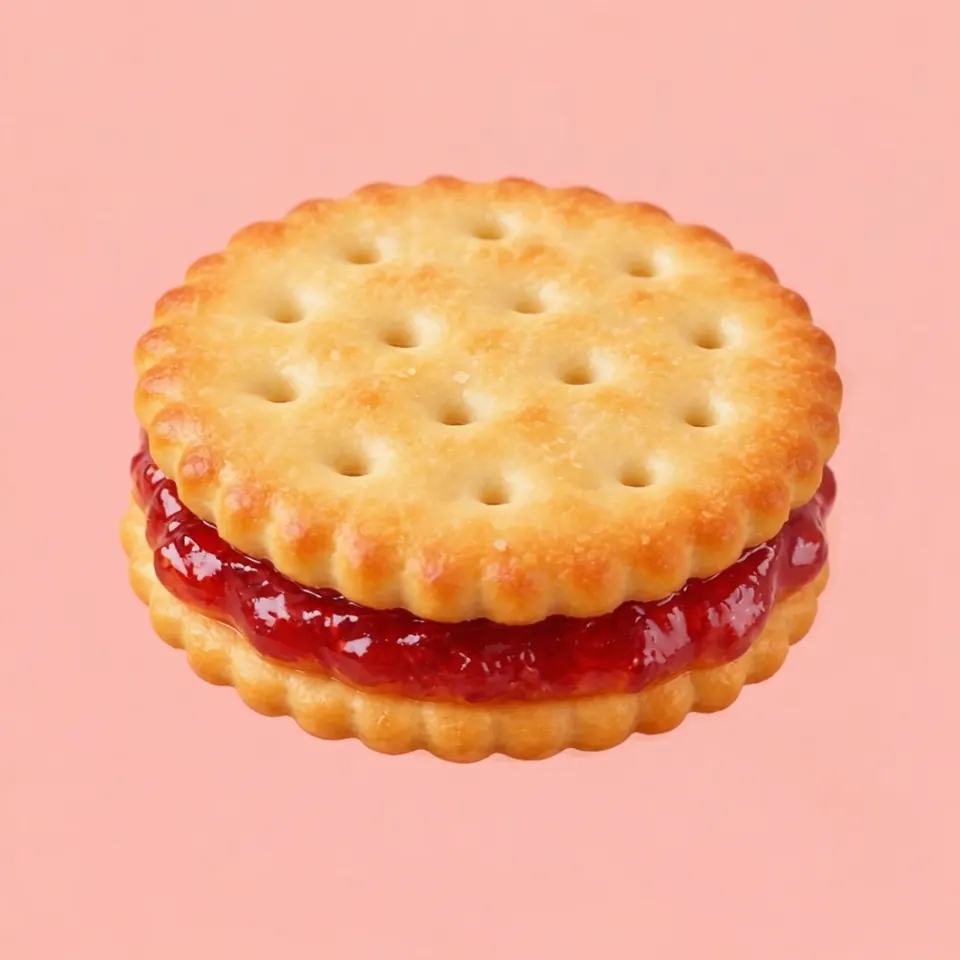
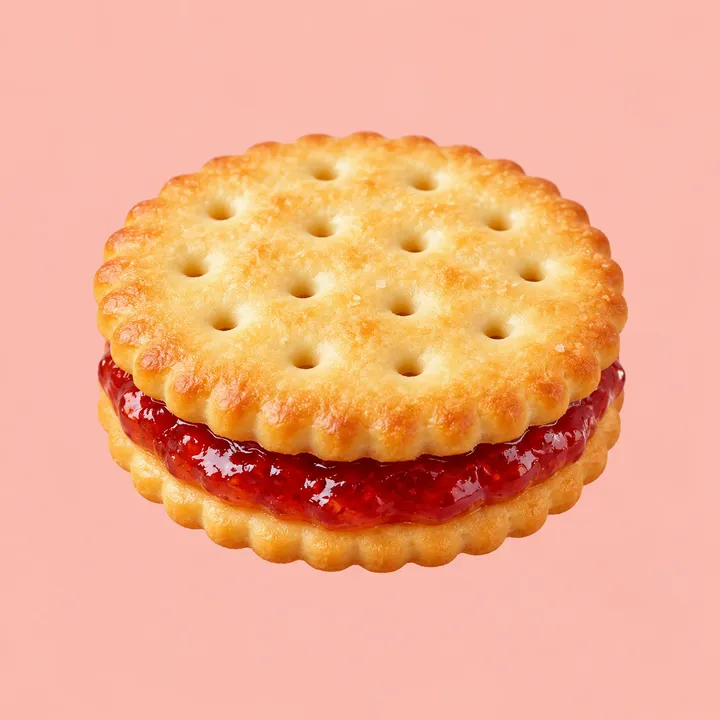
“A strawberry sandwich cookie slowly completes one full rotation while the camera moves smoothly around it and keeps the product centered.”Seedance 2.5, Bild-zu-Video, 5 s, mit Ton, 300 Credits, erstellt auf Dreamina, Eingabebild mit GPT Image 2 erstellt
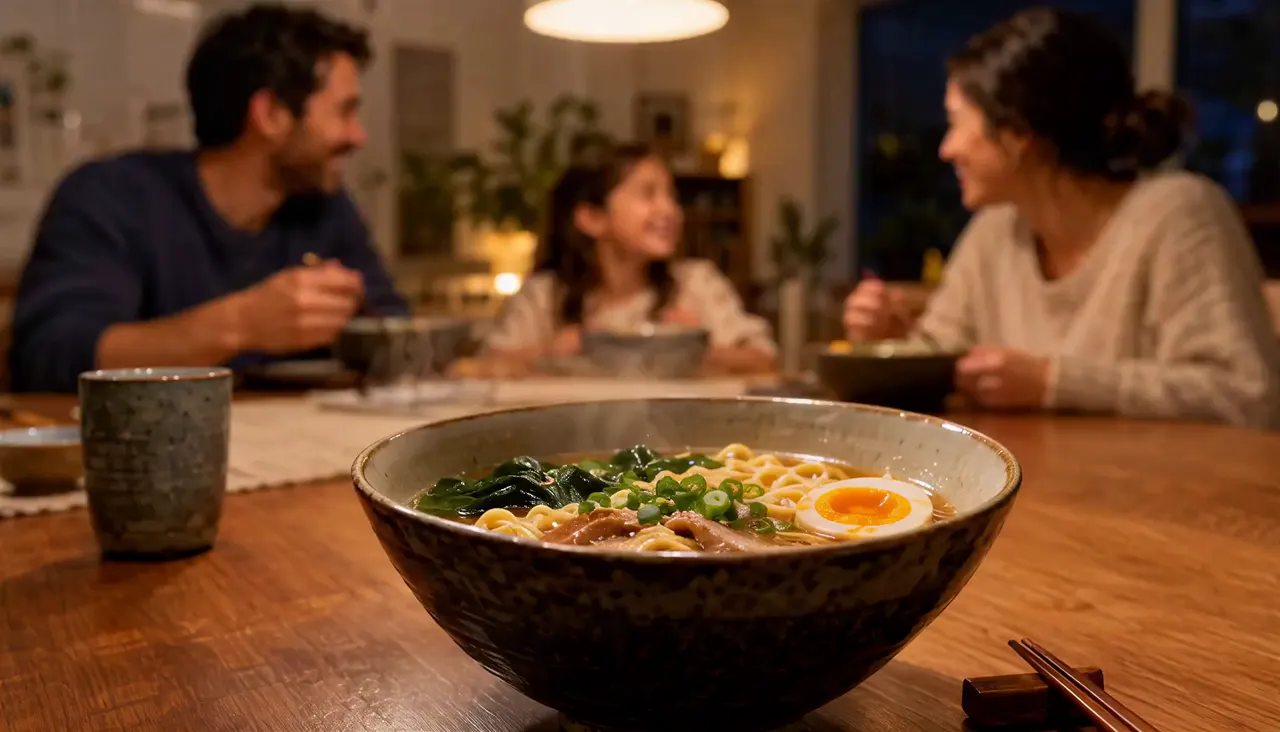
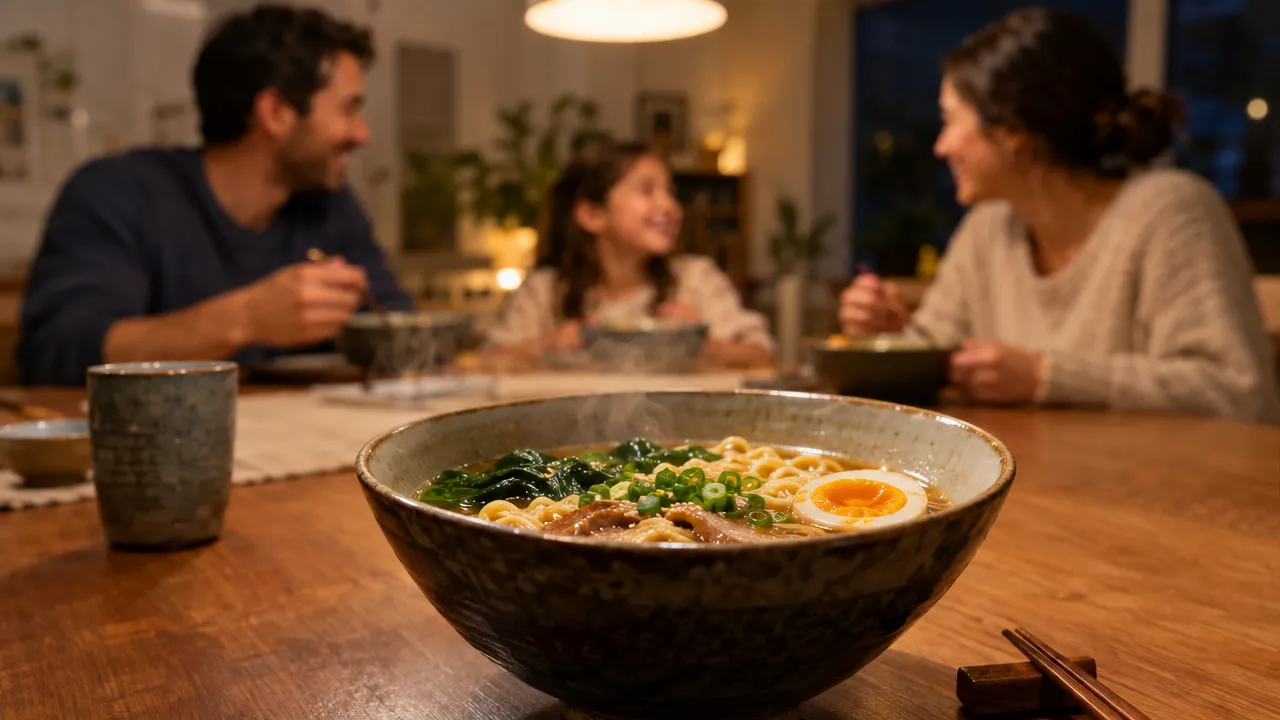
“Pull focus to the people in the background and add more steam to the ramen bowl.”MiniMax H3, Bild-zu-Video, 10 s, mit Ton, 260 Credits, Eingabebild mit GPT Image 2.5 erstellt
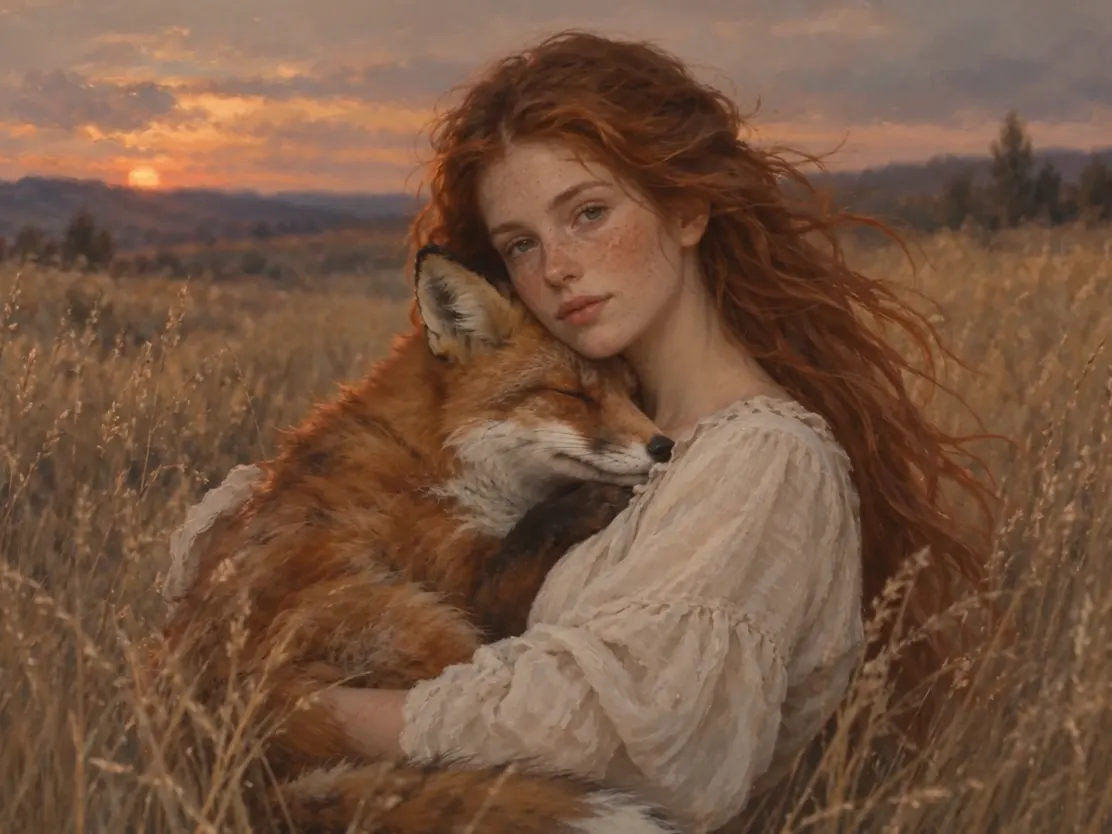
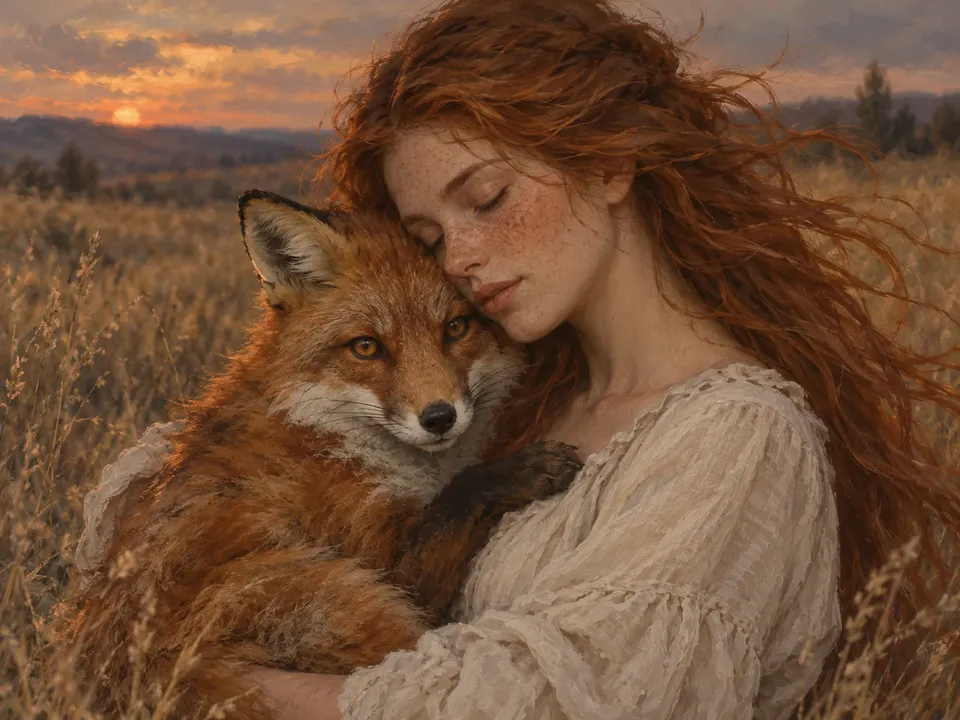
“A girl holds a fox. She opens her eyes and looks gently at the camera while the fox hugs her. The camera slowly pulls back, the wind blows through the girl's hair, and the sound of the wind can be heard.”Seedance 2.5, Bild-zu-Video, 5 s, mit Ton, 300 Credits, erstellt auf Dreamina, Eingabebild mit GPT Image 2 erstellt
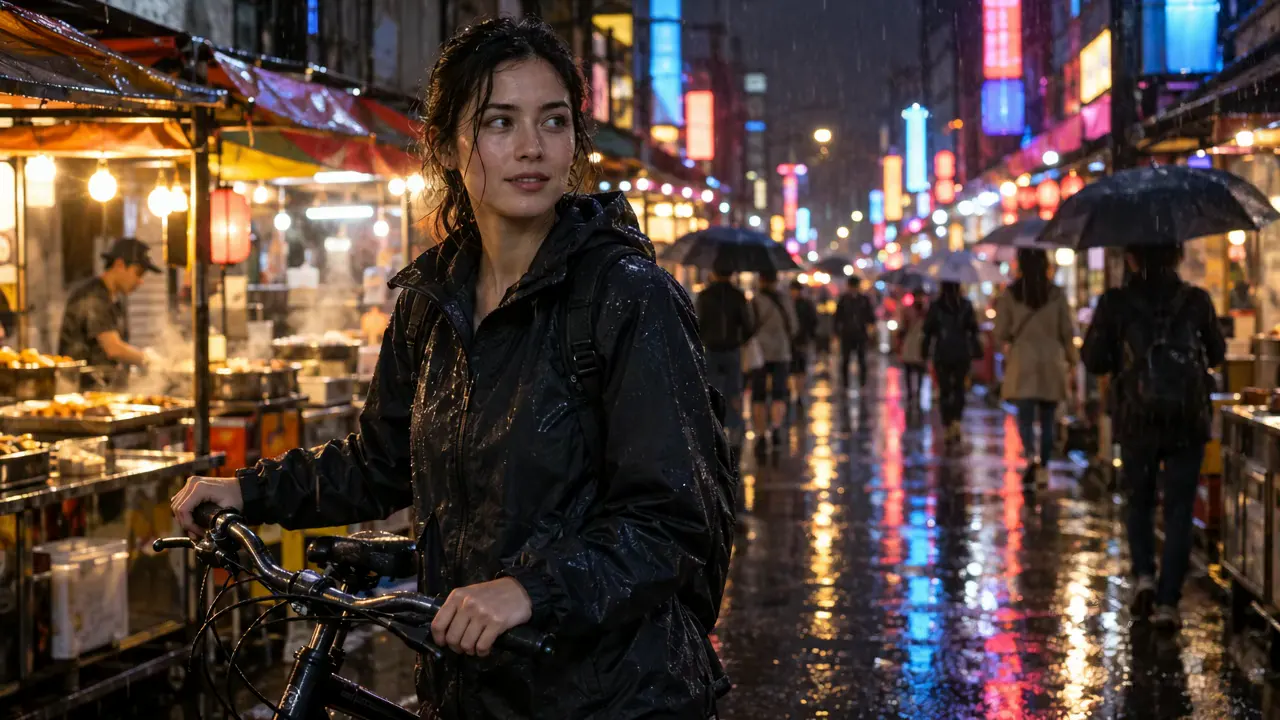
“Handheld shot on a rainy night market street. The woman with the bicycle turns her head to the camera and says: ‘I know a better place for noodles.’ Rain keeps falling, people with umbrellas walk past behind her, and neon signs reflect on the wet road. Audio: steady rain, distant street chatter, and her voice.”Wan 3.0, Bild-zu-Video, 5 s, mit Ton, 100 Credits, erstellt auf Wan, Eingabebild mit GPT Image 2.5 erstellt
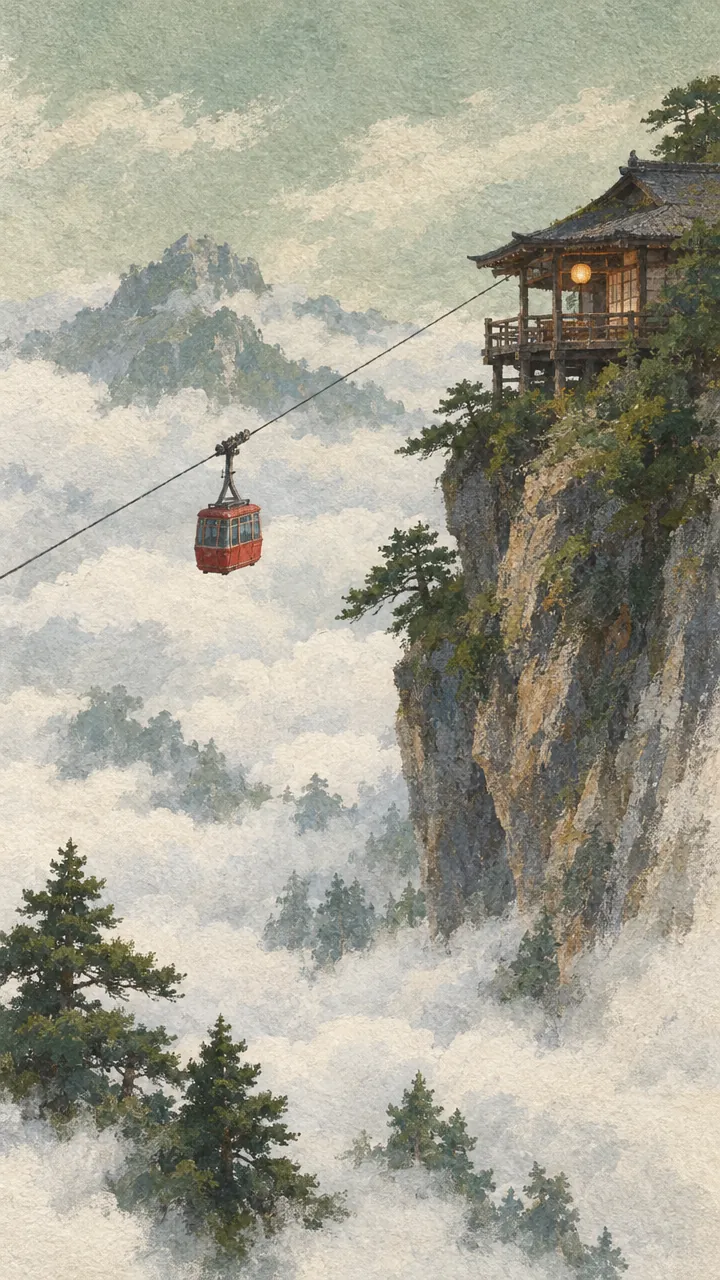
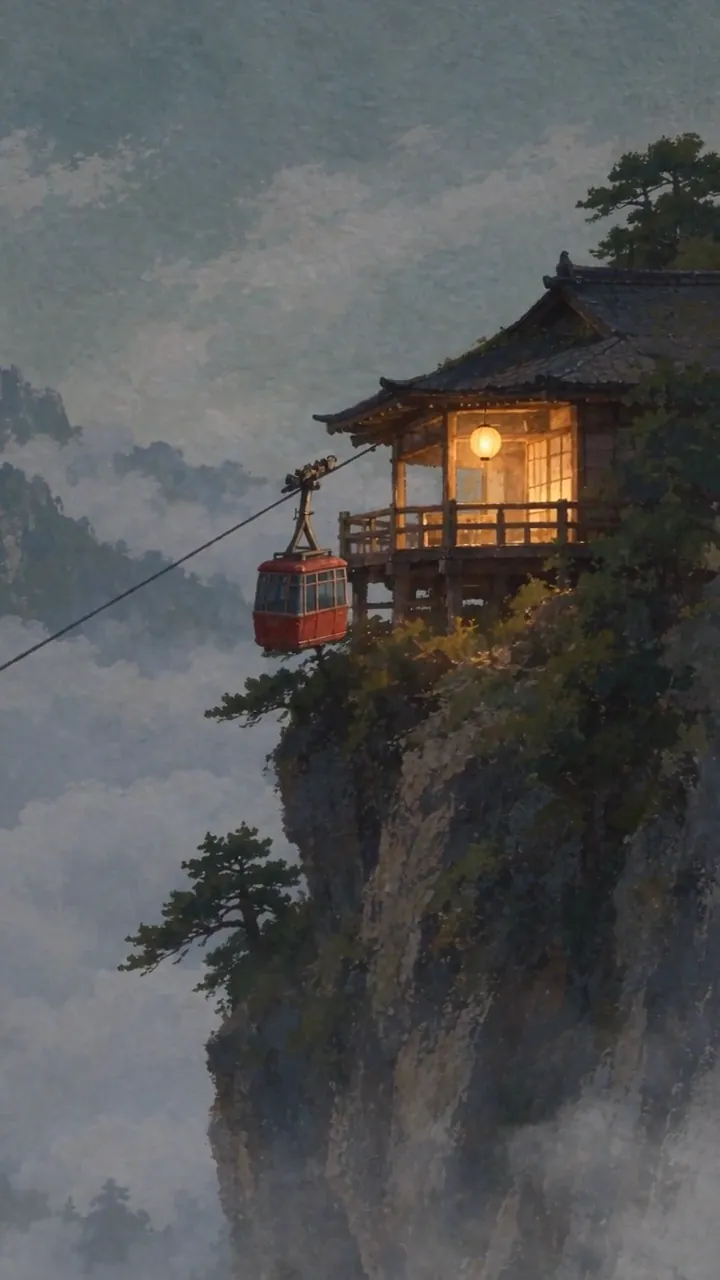
“The cable car sways and climbs slowly toward the top of frame. Cloud crosses the span from the right and hides the car completely for about a second, then the car comes back out on the same line, at the same speed, with the same sway. The lantern on the balcony swings and its light warms as the ambient light drops. The camera tilts up a few degrees to follow the climb. Every frame stays a gouache painting on rough paper: hold the brush texture, the dry-brush rock edges and the paper grain, and never let the image resolve toward photography. Audio: wind across the cable, the steel cable ticking through the sheave, one distant bell from the teahouse. No music.”Seedance 2.5, Bild-zu-Video, 10 s, mit Ton, 595 Credits, erstellt auf Dreamina, Eingabebild mit GPT Image 2.5 erstellt
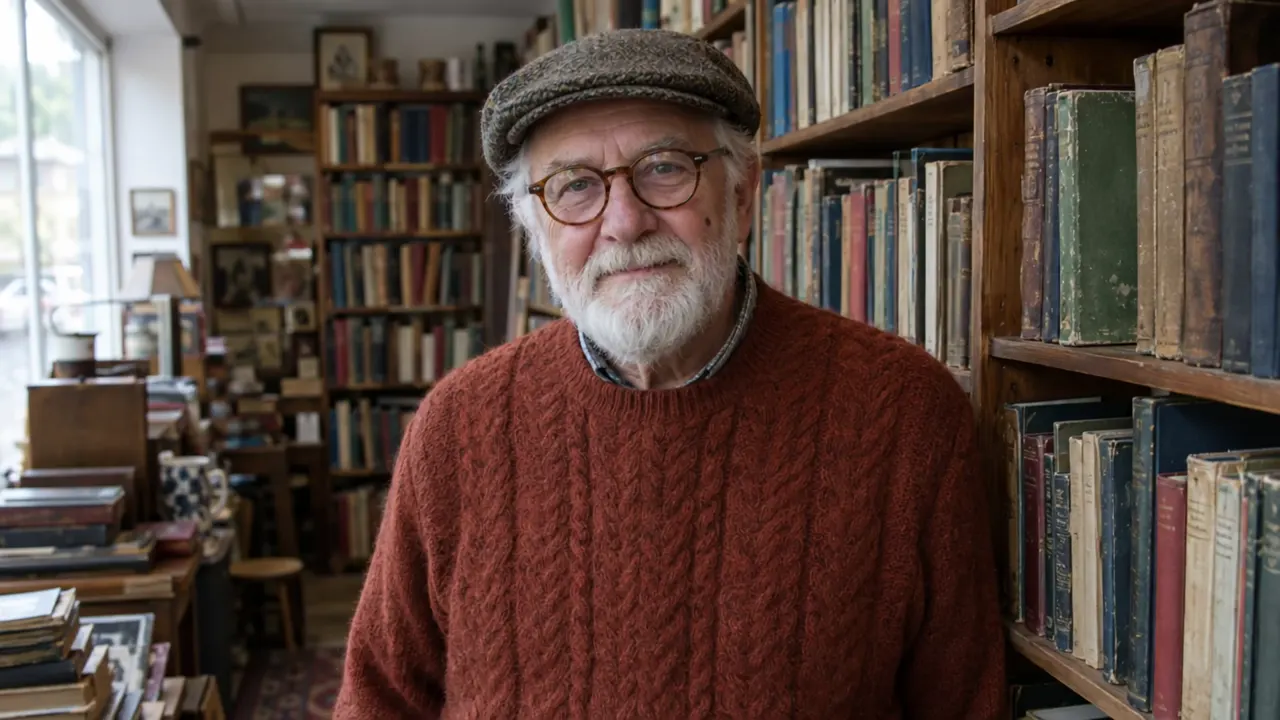
“He takes off his round tortoiseshell glasses and wipes the lenses on his rust sweater, then turns away to the shelf on the right and pulls out a faded green book. He turns back to the camera, puts the glasses back on, opens the book and looks up with a broad smile. The camera holds a steady medium shot with a slight drift. Sound: quiet shop room tone, the book sliding from the shelf, pages turning.”Kling 4.0, Bild-zu-Video, 8 s, mit Ton, 380 Credits, erstellt auf Kling AI, Eingabebild mit GPT Image 2.5 erstellt
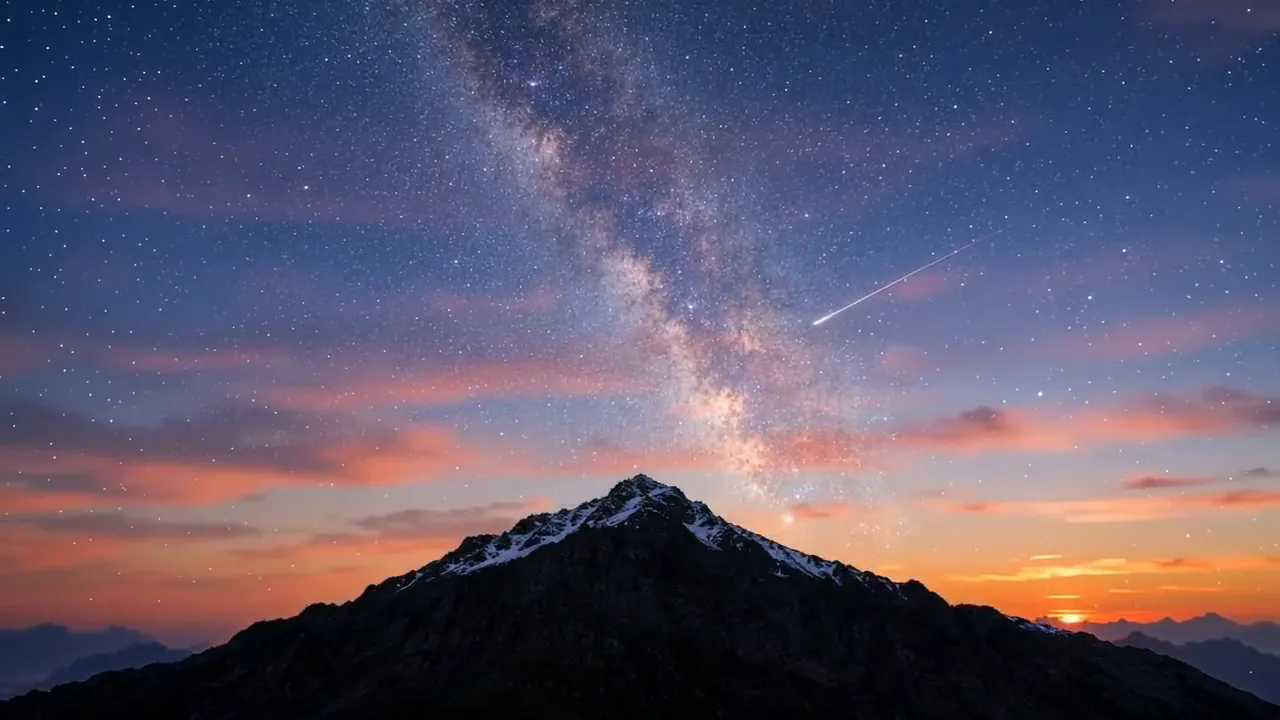
“I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Voiceover: A deep, serene male voice says: 'In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives.'”Wan 3.0, Bild-zu-Video, 10 s, mit Ton, 200 Credits, Eingabebild mit GPT Image 2.5 erstellt
So machst du aus einem Foto ein Video
1
Bild hochladen
JPG, PNG oder WebP mit bis zu 10 MB. Schneide es vorher auf das Format zu, das das Video haben soll – das Video übernimmt den Bildausschnitt.
2
Bewegung beschreiben
Schreib, was sich bewegt, wie sich die Kamera bewegt und was man hört. Beschreibe das Bild nicht noch einmal: Die Szene gibt das Bild schon vor.
3
Modell, Länge und Ton wählen
Zu Beginn ist Seedance 2.5 ausgewählt. Weiter unten siehst du alle vier Modelle mit demselben Bild im Vergleich; danach stellst du Länge, Auflösung und Ton ein. Der Preis passt sich an, bevor du etwas ausgibst.
4
Generieren und verfeinern
Die meisten Videos sind nach wenigen Minuten fertig und bleiben in deinem Verlauf. Stimmt die Bewegung nicht, ändere jeweils nur eine Sache im Prompt und generiere neu.
Videopreise gelten für 720p mit Ton (MiniMax H3: 768p), jeweils für die Version des Modells mit dem niedrigsten Preis; höhere Auflösungen kosten mehr. Der Arena-Platz ist die Platzierung samt Elo-Wert aus anonymen Paarvergleichen (AA-Video-I2V v2.1, with audio, Stand: 30. Oktober 2026) in der Artificial Analysis Image to Video Arena
Ein Bild, vier Modelle
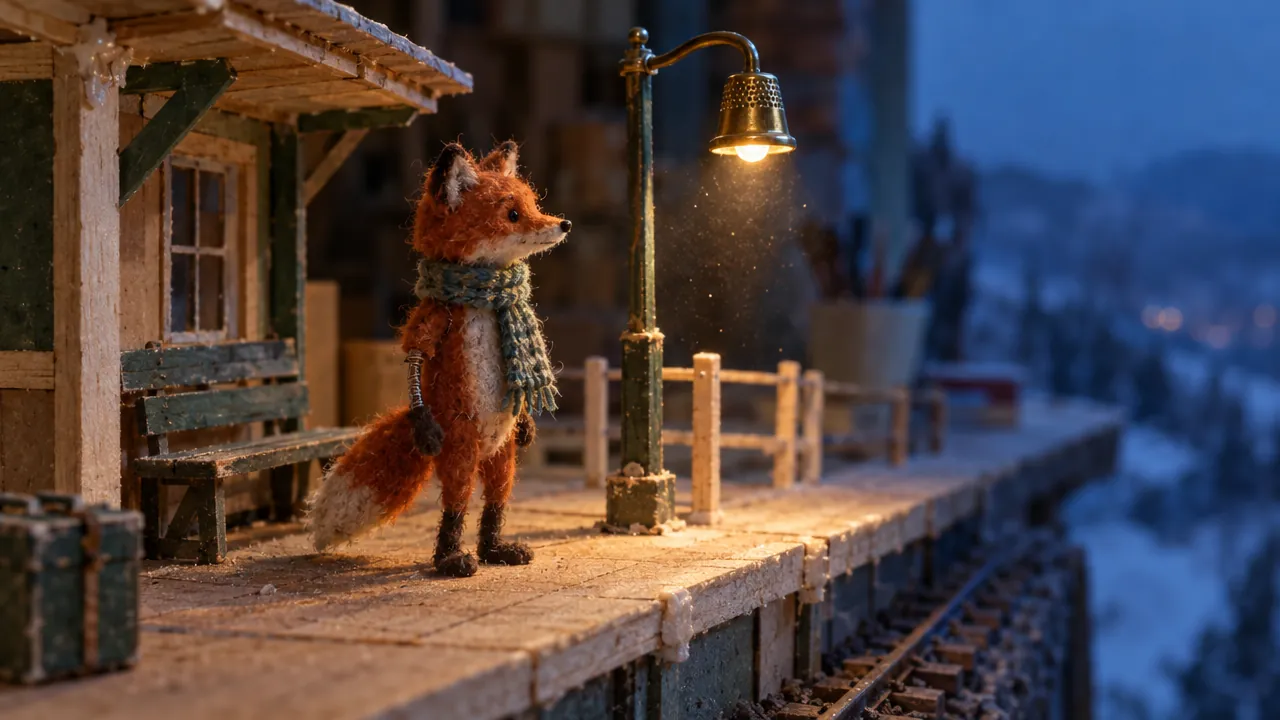
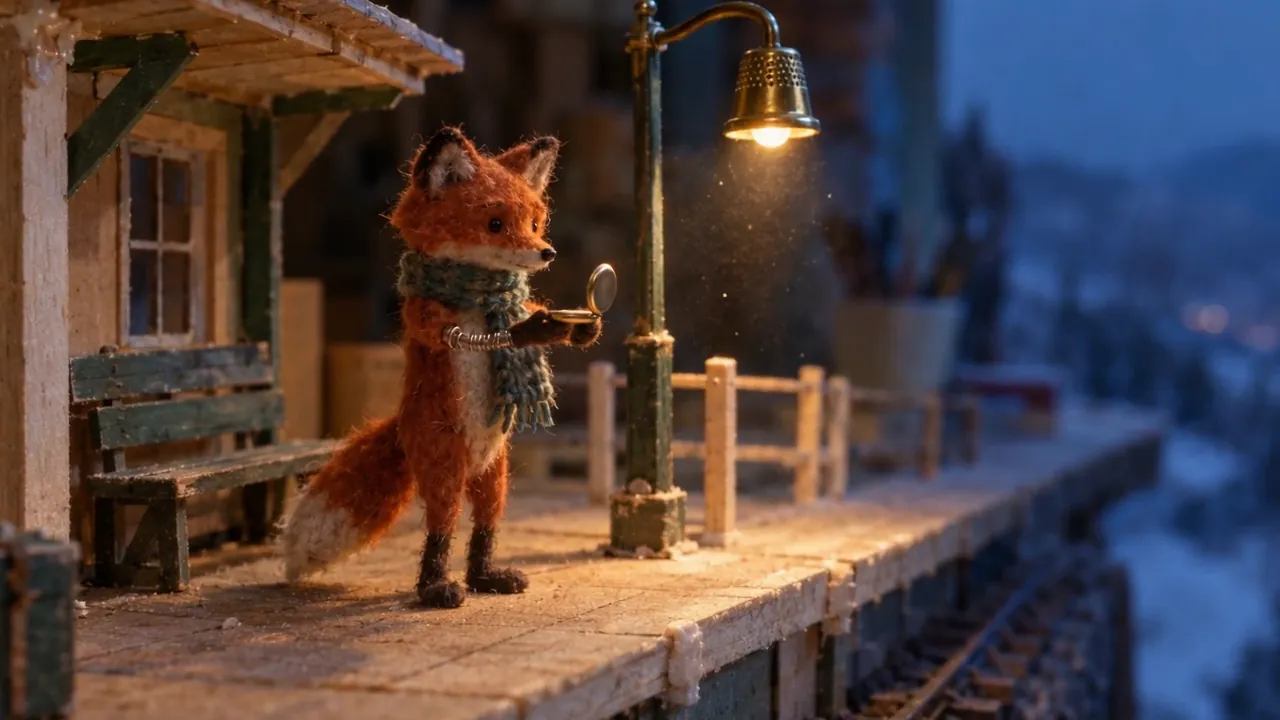
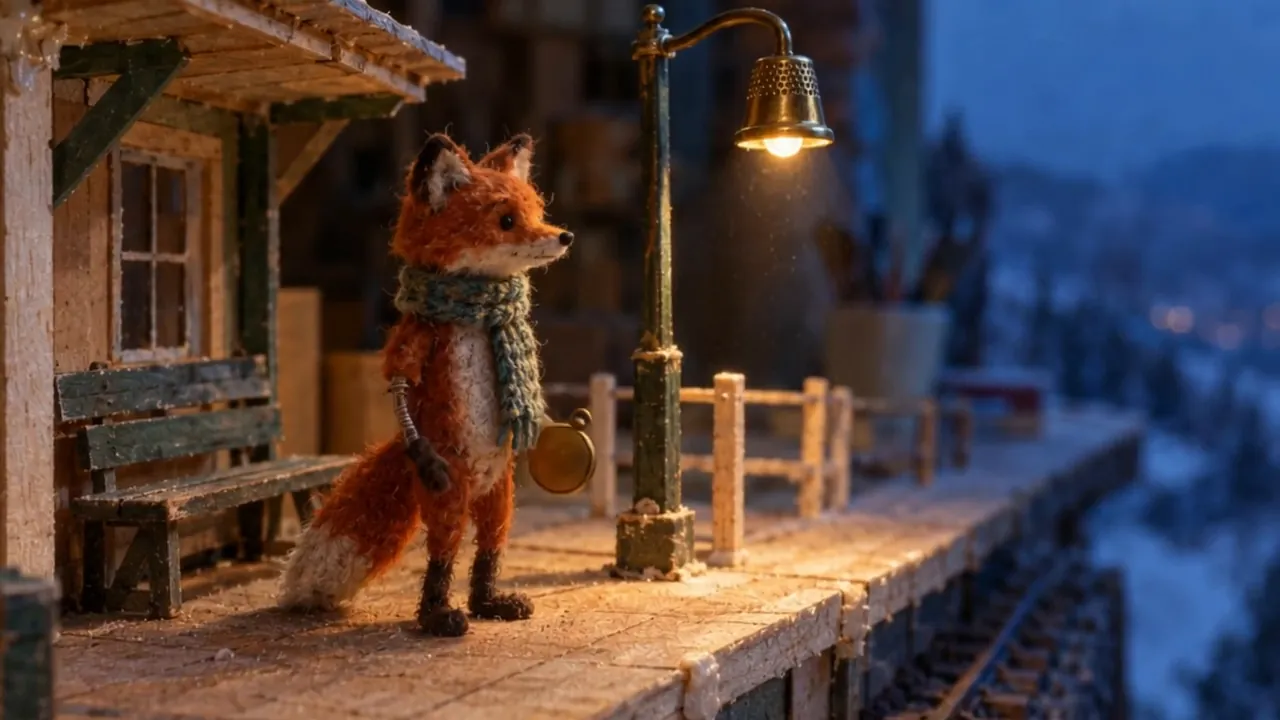
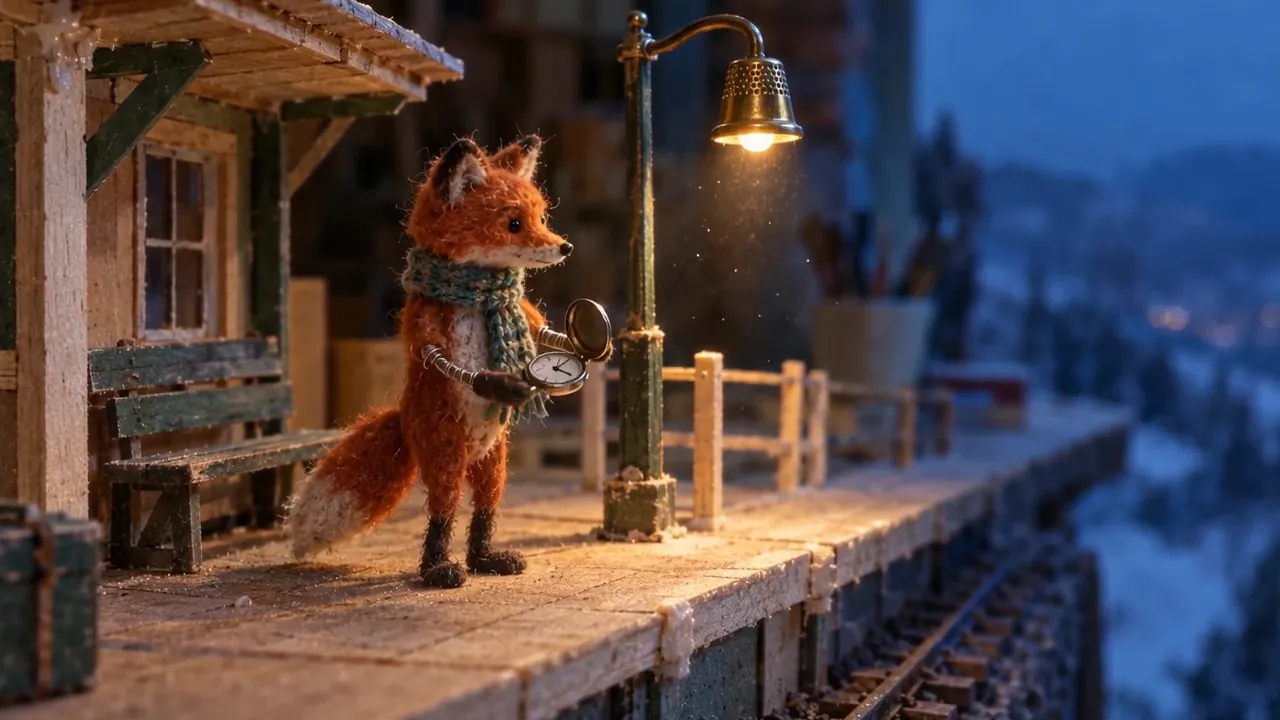
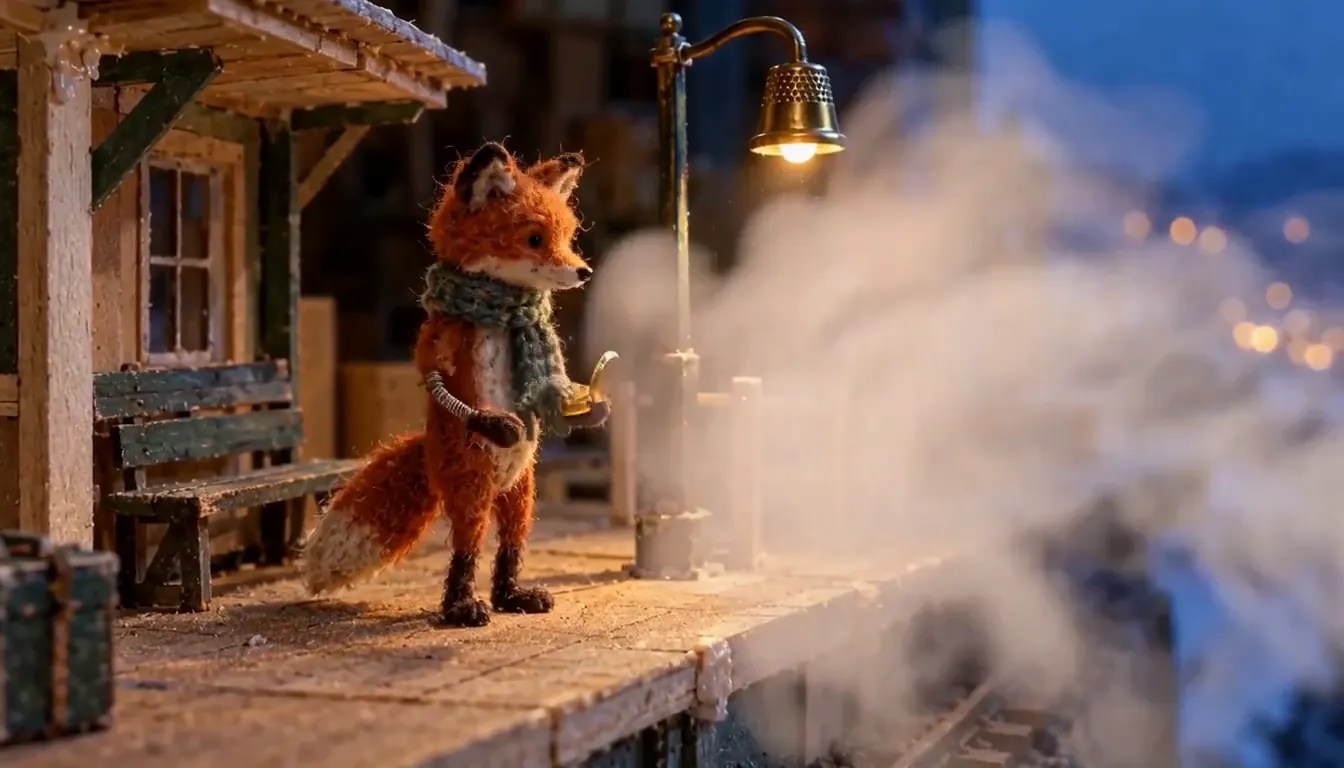
Ein Startbild und ein Prompt aus einem veröffentlichten Vergleich Seedance 2.5 vs. MiniMax H3, mit jedem Modell 10 Sekunden lang mit Ton generiert. Achte darauf, wie jedes Modell mit dem Dampf und der Kamera umgeht. Keins der vier lieferte die ruckartige Puppentrick-Bewegung mit zwölf Bildern pro Sekunde, die der Prompt verlangt.
Das Startbild, für jedes Modell gleich · Eingabebild mit GPT Image 2.5 erstellt
Derselbe Prompt und dieselben Einstellungen für jedes Modell:
“The fox turns his head down the track, raises one arm to check a pocket watch, lowers it. Steam drifts across from the right and covers him for roughly a second. He emerges in the pose he went in with, standing where he was standing, scarf hanging as it hung. The lamp flickers once. Slow push toward the platform. Throughout: twelve frames per second, stepped, no motion blur on the puppet, felt fibers readable, wire visible at the wrist, glue still on the balsa. The image must not resolve toward smooth CG or live action at any point. Sound: low hall reverb, the watch lid, steam venting, a station bell some distance off. Nothing scored.”
Bleibt in der Totalen. Der Fuchs hebt die Uhr zwischen Sekunde 2 und 5, bei etwa 6 Sekunden bedeckt Dampf das ganze Bild, und er taucht in derselben Pose wieder auf, wie es der Prompt verlangt. Am Ende eine leichte Fahrt nach vorn.
Hebt die Uhr und hält sie weiter hoch. Der Dampf bedeckt ihn nur teilweise, und die Kamera fährt bis zur Halbnahen heran: die stärkste Kamerafahrt der vier und der lauteste Ton.
Die schnellste Bewegung: Die Uhr ist schon in den ersten 1 bis 3 Sekunden oben. Der Dampf verdeckt ihn fast ganz, bevor er wieder auftaucht, und die Lichter hinter ihm werden heller.
Bild-zu-Video-Beispiele mit Prompts
Zu jedem Beispiel gibt es den genauen Prompt, die Einstellungen und den Preis. Übernimm es direkt in den Generator oben oder pass es vorher an.
erstellt auf Dreamina, Eingabebild mit GPT Image 2.5 erstellt
Seedance 2.5
Ein Gemälde, das ein Gemälde bleibt
Jedes Frame behält Pinselstrich und Papierstruktur der Gouache, während die Seilbahn hinauffährt und die Laterne wärmer leuchtet. Die Wolke verdeckt die Kabine etwa 3 Sekunden lang statt der einen Sekunde, die der Prompt verlangt – genau wie im Seedance-2.5-Durchlauf des ursprünglichen Tests.
Bild-zu-Video
720p
10 s
mit Ton
9:16
“The cable car sways and climbs slowly toward the top of frame. Cloud crosses the span from the right and hides the car completely for about a second, then the car comes back out on the same line, at the same speed, with the same sway. The lantern on the balcony swings and its light warms as the ambient light drops. The camera tilts up a few degrees to follow the climb. Every frame stays a gouache painting on rough paper: hold the brush texture, the dry-brush rock edges and the paper grain, and never let the image resolve toward photography. Audio: wind across the cable, the steel cable ticking through the sheave, one distant bell from the teahouse. No music.”
Tipp: Schreib, was sich nicht ändern darf: „hold the brush texture … never let the image resolve toward photography.“
595 Credits
erstellt auf Dreamina, Eingabebild mit GPT Image 2 erstellt
Seedance 2.5
Dein Produktfoto, das sich dreht
Mit dem Produktfoto als Startbild bleiben Form, Löcher und Marmelade beim Drehen genau wie auf dem Foto. Nur mit Text entstand ein anderer Keks.
Bild-zu-Video
720p
5 s
mit Ton
1:1
“A strawberry sandwich cookie slowly completes one full rotation while the camera moves smoothly around it and keeps the product centered.”
Tipp: Der Guide von ByteDance empfiehlt ein Eingabebild, das nicht größer ist als das Video (720p); schärfere Bilder können auf dichten Oberflächen zusätzliche Struktur erzeugen.
300 Credits
erstellt auf Kling AI, Eingabebild mit GPT Image 2.5 erstellt
Kling 4.0
Ein Foto einer Person, Schritt für Schritt
Brille ab, Gläser putzen, ein Buch aus dem Regal, Brille wieder auf, ein Lächeln: jeder Schritt in der richtigen Reihenfolge, und er und seine Brille bleiben wie auf dem Foto. Der Prompt stammt aus Fusers Vergleich Kling 4.0 vs. Kling 3.0; das Startbild ist unser eigenes.
Bild-zu-Video
1080p
8 s
mit Ton
16:9
“He takes off his round tortoiseshell glasses and wipes the lenses on his rust sweater, then turns away to the shelf on the right and pulls out a faded green book. He turns back to the camera, puts the glasses back on, opens the book and looks up with a broad smile. The camera holds a steady medium shot with a slight drift. Sound: quiet shop room tone, the book sliding from the shelf, pages turning.”
Tipp: Beschreibe, was sich bewegt und in welcher Reihenfolge – nicht das Bild.
380 Credits
erstellt auf Wan, Eingabebild mit GPT Image 2.5 erstellt
Wan 3.0
Ein Porträt, das spricht
Sie dreht sich zur Kamera und sagt ihren Satz, während hinter ihr Menschen mit Regenschirmen vorbeigehen. In Fusers Test mit diesem Prompt lehnte Seedance 2.5 das Foto als mögliche echte Person ab; Wan 3.0 animierte es.
Bild-zu-Video
720p
5 s
mit Ton
16:9
“Handheld shot on a rainy night market street. The woman with the bicycle turns her head to the camera and says: ‘I know a better place for noodles.’ Rain keeps falling, people with umbrellas walk past behind her, and neon signs reflect on the wet road. Audio: steady rain, distant street chatter, and her voice.”
Tipp: Animiere nur Fotos von dir selbst oder von Menschen, die zugestimmt haben.
100 Credits
Eingabebild mit GPT Image 2.5 erstellt
Wan 3.0
Zeitraffer einer Landschaft mit Sprecherstimme
Die Sterne stehen die ersten vier Sekunden still, dann färbt sich der Horizont orange, und der Himmel endet in einer rosa Morgendämmerung, während die Milchstraße verblasst – dazu eine Sprecherstimme. Der Prompt stammt aus dem Guide von ByteDance zu Seedance 2.0, ohne die letzte Zeile, die eingebrannten Text verlangte.
Bild-zu-Video
720p
10 s
mit Ton
16:9
“I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Voiceover: A deep, serene male voice says: 'In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives.'”
Tipp: Nenne die Veränderung über die Zeit („from a starry night to a vibrant dawn“); das Bild legt nur den Anfang fest.
200 Credits
Eingabebild mit GPT Image 2.5 erstellt
MiniMax H3
Schärfeverlagerung in 2K
Eine einzige Anweisung, formuliert wie eine Fotobearbeitung, verlagert die Schärfe von der Schüssel auf die Familie dahinter und fügt Dampf hinzu. Der Prompt ist das eigene Bild-zu-Video-Beispiel von MiniMax.
Bild-zu-Video
2K
10 s
mit Ton
16:9
“Pull focus to the people in the background and add more steam to the ramen bowl.”
Tipp: Bilder mit klarem Vorder- und Hintergrund geben einer Schärfeverlagerung etwas, zwischen dem sie wechseln kann.
260 Credits
Eingabebild mit GPT Image 2.5 erstellt
MiniMax H3
Ein Standbild, das sich kaum bewegt
Mit H3 Max Turbo, der Option mit dem niedrigsten Preis hier, ist die Bewegung sehr dezent – genau das, was die letzten Worte des Prompts verlangen: „Extremely slow, quiet motion“.
Bild-zu-Video
768p
5 s
mit Ton
16:9
“Two heavy draft horses stand together in a shallow flooded pasture at dusk — a chestnut with a long flaxen-copper mane, head lowered and turned inward, resting against the shoulder of a dark dapple-grey with black feathered legs. Ankle-deep still water mirrors them almost perfectly. Golden-hour side light, pale peach and dove-grey sky, bare winter trees and a red-roofed barn far in the background with small grazing horses. Extremely slow, quiet motion”
Tipp: Wenn du mehr Bewegung willst, mach sie zur Haupthandlung und schreib, wie groß sie sein soll.
40 Credits
erstellt auf Dreamina, Eingabebild mit GPT Image 2 erstellt
Seedance 2.5
Eine Illustration wird lebendig
Das Startbild ist ein Gemälde. Das Video behält den Pinselstrich, während sie die Augen öffnet und in die Kamera schaut und der Fuchs sich an sie schmiegt. Der Prompt stammt Wort für Wort aus dem Tutorial von ByteDance.
Bild-zu-Video
720p
5 s
mit Ton
4:3
“A girl holds a fox. She opens her eyes and looks gently at the camera while the fox hugs her. The camera slowly pulls back, the wind blows through the girl's hair, and the sound of the wind can be heard.”
Tipp: Eine Handlung und eine Kamerabewegung pro Video.
300 Credits
So schreibst du einen Prompt für Bild-zu-Video
Was in den Prompt gehört – in der Reihenfolge, die die Modelle zuverlässig verarbeiten.
Die Bewegung beschreiben, nicht das Bild
Motiv, Ort, Licht und Stil gibt das Bild vor. Nutze den Prompt für das, was sich ändert: wer sich bewegt, wie und in welcher Reihenfolge.
“He takes off his round glasses, wipes the lenses on his sweater, then puts them back on and looks up.”
Eine Kamerabewegung, mit Tempo
Wähle eine einzige Bewegung, etwa eine langsame Fahrt nach vorn, einen Bogen nach links oder eine statische Einstellung. Der Guide von ByteDance warnt, dass mehrere Bewegungen in einer Einstellung sie instabil machen.
“Slow push toward the platform.”
Schreiben, was gleich bleiben muss
Videomodelle machen gern aus Gemälden Fotos und aus Requisiten neue. Nenne, was halten muss: den Stil, die Form des Produkts, das Etikett, die Pose am Ende.
“Every frame stays a gouache painting on rough paper: hold the brush texture and the paper grain.”
Reihenfolge und Timing festlegen
Wenn etwas vor etwas anderem passieren muss, schreib es. In Fusers Test mit Wan 3.0 fing die Kerze Feuer, während der Sonnenfleck noch an der Wand war; Fuser rät, „first … only then …“ zu schreiben.
“First the candle catches, only then the sun patch fades from the wall.”
Die Bewegung zur Länge passend halten
In ein Video von 5 Sekunden passt eine Handlung. Bei schnellen, großen Bewegungen verzerren alle Modelle Hände und Gegenstände – verlangsame sie also oder teile sie auf mehrere Videos auf.
Den Ton vorgeben
Beschreib Atmosphäre und Effekte und setz gesprochene Sätze in Anführungszeichen. Beende den Prompt mit „No background music“, wenn du keine Musik willst; sonst wählt das Modell selbst welche.
“Audio: wind across the cable, one distant bell. No music.”
Regeln für dein Bild
Datei: JPG, PNG oder WebP, bis zu 10 MB. Schneide das Bild vorher auf das gewünschte Seitenverhältnis zu.
Größe: Etwa die Auflösung des Videos reicht. Der Guide von ByteDance empfiehlt für Seedance 2.5 ein Eingabebild, das nicht größer ist als das Video, weil ein deutlich schärferes Bild auf dichten Oberflächen eine Struktur wie von Fingerabdrücken erzeugen kann.
Personen: Lade nur Fotos von dir selbst oder von Menschen hoch, die zugestimmt haben – nie von Personen des öffentlichen Lebens und nichts Sexuelles mit einer echten Person. Seedance 2.5 lehnt Fotos mit echten Gesichtern ab; die anderen drei animierten in unabhängigen Tests fotorealistische Porträts.
Rechte: Vor deinem ersten Upload bestätigst du, dass dir das Bild gehört oder du es verwenden darfst. Jeder Upload und jedes Ergebnis wird anhand unserer Nutzungsrichtlinie geprüft.
Welches Bild-zu-Video-Modell passt zu dir?
Seedance 2.5 vom TikTok-Mutterkonzern ByteDance hält einen Stil am zuverlässigsten. Es bewahrte die Gouache-Struktur unseres Gemäldes und die Pose, die der Fuchs-Prompt verlangte, mit einem ruhigen, filmischen Ton. Pro Sekunde ist es das teuerste der vier, und es lehnt Fotos echter Menschen ab.
Kling 4.0 (Kling AI) vom chinesischen Kurzvideo-Anbieter Kuaishou bewahrt Person und Requisiten aus deinem Startbild: Laut Fuser entspricht sein erstes Frame dem Eingabebild „almost to the pixel“, und unseren Buchladen-Prompt setzte es Schritt für Schritt um. Es macht die größten Kamerabewegungen und den lautesten Ton und läuft bis zu 30 Sekunden (Fuser).
Wan 3.0 von Alibaba animiert Fotos von Menschen, die Seedance ablehnt, läuft bis zu 30 Sekunden und kostet pro Sekunde weniger. Wenn der Prompt etwas verlangt, das das Bild nicht hergibt, folgt es dem Bild (Atlas Cloud).
MiniMax H3 (Hailuo AI) vom KI-Unternehmen MiniMax ist der Weg mit dem niedrigsten Preis, um Bewegung an einem Bild auszuprobieren (H3 Max Turbo), und das einzige Modell hier mit 2K (die offizielle Version H3). In unserem Fuchs-Test bewegte es sich am schnellsten von den vieren und machte die Lichter in der Szene heller.
Bild-zu-Video oder Text-zu-Video?
Nimm Bild-zu-Video, wenn das Video zu etwas passen muss, das du schon hast: deinem Produkt, einer Figur, einem Gemälde, einem Foto. Nimm Text-zu-Video, wenn du mit einer Idee startest. Brauchst du ein Bild, das es noch nicht gibt, erstellst du es mit dem KI-Bildgenerator oder mit KI-Produktfotos und animierst es dann hier; die meisten Startbilder auf dieser Seite sind so entstanden.
So sind die Beispiele auf dieser Seite entstanden
Zu jedem Beispiel siehst du Startbild, Prompt, Modell und Einstellungen sowie den heutigen Preis auf zzo.ai. Die Prompts stammen aus veröffentlichten Tests und den Guides der Hersteller, die auf jeder Karte genannt sind, und der Vergleich oben nutzt ein Bild und einen Prompt für alle vier Modelle. Die Prompts sind auf Englisch, so wie das Modell sie bekommen hat. Einige Videos wurden in der App des Modellherstellers mit demselben Modell, Prompt und denselben Einstellungen erstellt und sind entsprechend gekennzeichnet. Kein Video ist nachbearbeitet, und wo ein Video einen Teil des Prompts verfehlt hat, steht es auf der Karte.
Wenn ein Ergebnis danebengeht
Die typischen Probleme, woher sie kommen und was du ändern solltest.
Das Bild wird als echte Person abgelehnt
Ursache: Seedance 2.5 akzeptiert keine Fotos mit echten menschlichen Gesichtern.
Lösung: Nutze Kling 4.0, Wan 3.0 oder MiniMax H3 mit einem Foto, für das du eine Einwilligung hast, oder eine gezeichnete oder KI-generierte Figur. Die Credits für den abgelehnten Durchlauf kommen automatisch zurück.
Das Video ignoriert einen Teil des Prompts
Ursache: Wenn Bild und Prompt sich widersprechen, setzt sich meist das Bild durch: Tester sahen, wie Wan 3.0 aus Regen in einem Innenraum nur „a lighting change and a token splash“ machte.
Lösung: Verlange Bewegungen, die das Bild hergibt, oder ändere zuerst das Bild mit der KI-Bildbearbeitung.
Ränder oder Bildausschnitt stimmen nicht
Ursache: Das Video übernimmt das Format des Bildes. MiniMax H3 machte in einem Test aus einem Standbild in 9:16 ein Video im Format 4:7.
Lösung: Schneide das Bild vor dem Hochladen auf das gewünschte Seitenverhältnis zu, mit dem Motiv nicht zu nah am Rand.
Gesicht oder Produkt verändern sich im Lauf des Videos
Ursache: Große Drehungen und schnelle Bewegungen zwingen das Modell, zu erfinden, was das Foto nicht zeigt.
Lösung: Lass das Motiv ungefähr in dieselbe Richtung schauen, verlangsame die Bewegung und schreib, was sich nicht ändern darf.
Das Gemälde wird zum Foto
Ursache: Videomodelle werden vor allem mit Filmaufnahmen trainiert und driften deshalb zum Foto-Look.
Lösung: Nenne im Prompt die Maltechnik und ihre Struktur und verlange, dass das Modell sie in jedem Frame beibehält.
Das Video wurde abgelehnt oder ist fehlgeschlagen
Ursache: Der Filter des Modells oder unsere Richtlinienprüfung hat Bild, Prompt oder Ergebnis blockiert, oder das Modell hat das Zeitlimit überschritten.
Lösung: Es wird nichts berechnet: Die Credits kommen automatisch zurück. Sieh dir die Nutzungsrichtlinie an und probier ein anderes Bild oder eine andere Formulierung.
Häufige Fragen
Aktualisiert am 30. Oktober 2026
Welche Bild-zu-Video-KI ist gerade die beste?
In der Bild-zu-Video-Rangliste von Artificial Analysis, die auf blinden Paarvergleichen beruht, liegt Seedance 2.5 auf Platz 1, MiniMax H3 dicht dahinter und Wan 3.0 unter den ersten zehn (Platzierungen und Abrufdatum stehen oben auf dieser Seite). Kling 4.0 ist dort noch nicht gelistet. Im Abschnitt „Ein Bild, vier Modelle“ weiter oben kannst du alle vier mit demselben Bild vergleichen.
Welches Bild eignet sich am besten?
Ein scharfes JPG, PNG oder WebP mit bis zu 10 MB, mit klarem Motiv und im selben Format wie das gewünschte Video. Das erste Frame des Videos ist dein Bild, deshalb tragen sich Bildaufbau, Licht und Farben ins Video weiter. Collagen und Screenshots mit kleinem Text lassen sich schlecht animieren.
Darf ich ein Foto von einer Person animieren?
Nur ein Foto von dir selbst oder von jemandem, der zugestimmt hat, und nie von Personen des öffentlichen Lebens. Seedance 2.5 lehnt Fotos ab, die wie echte Menschen aussehen; in unabhängigen Tests animierten Kling 4.0, Wan 3.0 und MiniMax H3 fotorealistische Porträts, die Seedance abgelehnt hatte. Gezeichnete und KI-generierte Figuren funktionieren mit jedem Modell.
Kann ich alte Familienfotos lebendig machen?
Ja, wenn die abgebildeten Personen eingewilligt haben oder es deine eigenen Familienfotos sind, die du verwenden darfst. Nutze Kling 4.0, Wan 3.0 oder MiniMax H3 und halte die Bewegung klein, etwa ein Lächeln oder eine Kopfdrehung, damit die Gesichter dem Foto treu bleiben.
Kann ich aus einem Produktfoto ein Werbevideo machen?
Ja, etwa für Instagram Reels, TikTok oder deinen Onlineshop. Lade ein sauberes Produktfoto hoch und beschreibe eine langsame Bewegung, zum Beispiel eine Drehung oder eine Fahrt nach vorn. Das Produkt behält seine Form vom Foto viel besser als bei einem Video nur aus Text. Ein besseres Startbild erstellst du vorher mit KI-Produktfotos.
Was kostet es, ein Foto zu animieren?
Das hängt von Modell, Länge, Auflösung und Ton ab. Die Tabelle auf dieser Seite zeigt für jedes Modell den Preis für 5 und 10 Sekunden, und der Generator zeigt dir den genauen Preis, bevor du startest. Ein Abo gibt es nicht.
Wie lang kann das Video sein?
Bis zu 30 Sekunden mit Kling 4.0 und Wan 3.0, bis zu 15 Sekunden mit Seedance 2.5 und MiniMax H3. Für mehr erstellst du das nächste Video aus dem letzten Frame des vorherigen und fügst beide im Schnittprogramm zusammen.
Hat das Video Ton?
Ja, jedes Modell hier erzeugt den Ton zusammen mit dem Bild. Schreib die Geräusche und gesprochenen Sätze in den Prompt. Bei Seedance 2.5 und Wan 3.0 kannst du den Ton abschalten.
Kann ich das Seitenverhältnis wählen?
Das Video übernimmt das Format deines Bildes, schneide es also vorher zu: 9:16 im Hochformat für TikTok, Instagram Reels und YouTube Shorts, 16:9 im Querformat für YouTube, 1:1 für Feeds.
Warum sieht mein Video nicht aus wie mein Foto?
Große Bewegungen zwingen das Modell, zu erfinden, was das Foto nicht zeigt. Verlange kleinere, langsamere Bewegungen, lass das Motiv in dieselbe Richtung schauen und schreib, was gleich bleiben muss.
Was passiert, wenn eine Generierung fehlschlägt oder abgelehnt wird?
Die Credits für dieses Video kommen automatisch auf dein Guthaben zurück – egal ob das Modell fehlgeschlagen ist, das Zeitlimit überschritten oder das Bild abgelehnt hat oder ob unsere Richtlinienprüfung das Ergebnis blockiert hat.
Darf ich die Videos kommerziell nutzen?
Ja, wenn du die Rechte an dem hochgeladenen Bild hast und das Ergebnis unseren Nutzungsbedingungen entspricht. Die Videos, die du generierst, darfst du verwenden.
Brauche ich ein Abo?
Nein. Du kaufst ein Credit-Paket, bezahlst einmalig und nutzt die Credits für jedes Modell, auf der Website oder über die API. Nichts verlängert sich automatisch, und deine Credits verfallen nicht.