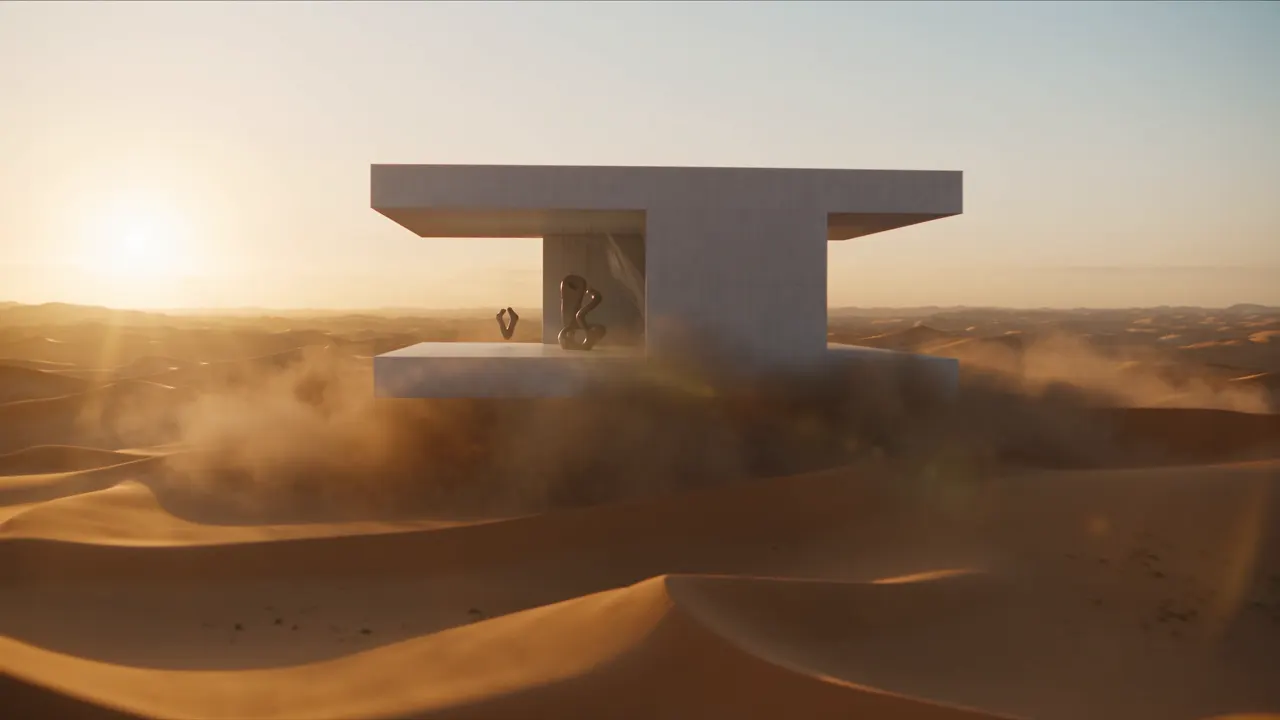
Museo flotante en el desierto

Texto a video: de un prompt a un video con IA y audio

4 modelos crean clips de 4 a 30 segundos hasta 2K; 4 de ellos agregan audio. Los clips cuestan desde 25 créditos (USD 0.25), sin suscripción y con créditos que no vencen. En la Artificial Analysis Text to Video Arena (revisada el 30 de octubre de 2026): Wan 3.0 ocupa el puesto 1 (Elo 1,175), MiniMax H3 el 3, Seedance 2.5 el 4.

Escribe lo que debe pasar, elige un modelo y en unos minutos recibes un video con audio. Así funciona el texto a video con IA en zzo.ai: ves el precio antes de generar, pagas con créditos de un paquete que compras una sola vez, sin suscripción ni cobros automáticos, y si una generación falla, te devolvemos los créditos automáticamente.

Prompt de este video. Edítalo o escribe el tuyo.

Hecho con estos modelos

Cada uno muestra el prompt, el modelo y lo que cuesta aquí. Elige uno para empezar a partir de él.

Museo flotante en el desierto
“Cinematic quality, high-end feel, a golden desert at dawn, a minimalist white art-museum building floating above the dunes, the building's surface carrying fine stone texture and soft reflections. Sunlight passes through the airborne sand to form volumetric light, with distinct layers of distant dunes. The camera starts on an ultra-wide desert panorama, slowly pushing forward, passing through the flying sand grains, into the interior of the floating building. Inside there are suspended sculptures, semi-transparent silk installations, and a character in a white robe, the fabric swaying naturally in the wind. The camera makes a smooth orbiting move around the character, and finally the building walls slowly open to reveal the vast sky and desert. High-end art-advertising style, realistic lighting, refined materials, cinematic composition, elegant motion, surreal yet believable.”Seedance 2.5, 15 s, con audio, 890 créditos, hecho en Dreamina
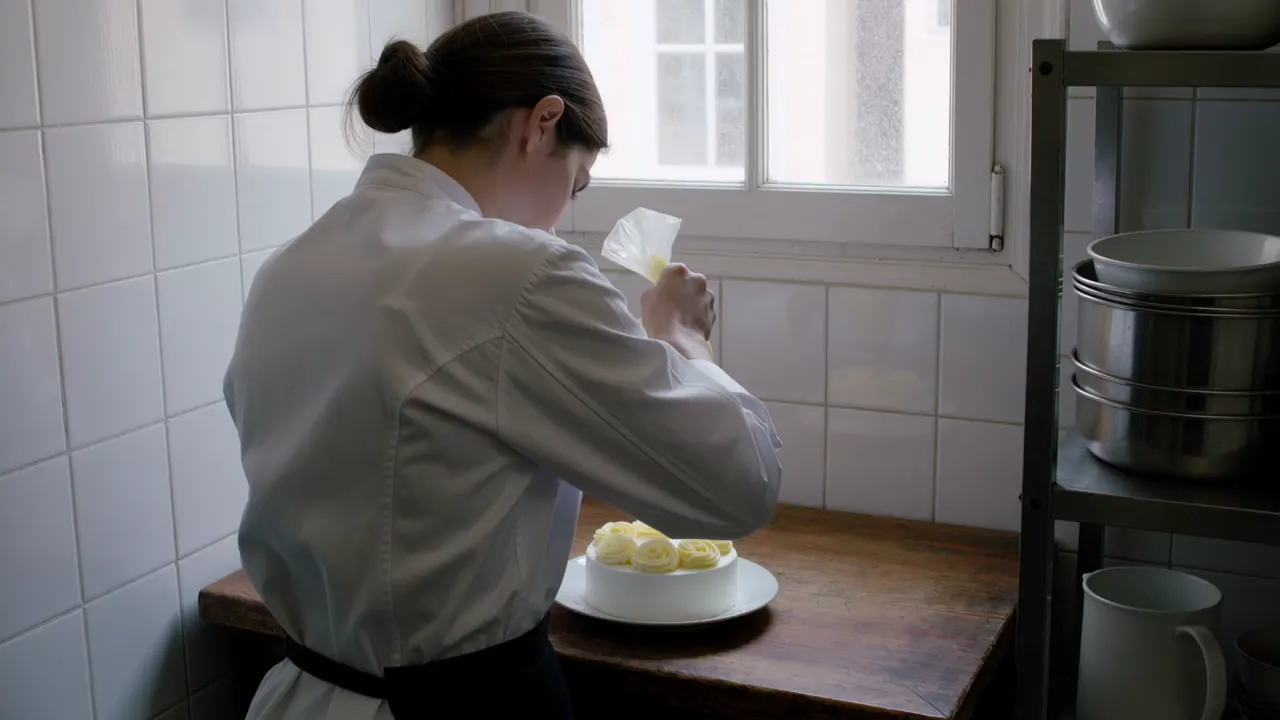
Pastelera, una sola toma de 30 segundos
“One unbroken handheld take, direct-flash 35mm snapshot look, fine grain, white tile and bright window light. 0-5s: from behind, a young pastry cook in a white jacket and a long black apron pipes the last pale-yellow buttercream flowers onto a small white cake on a scrubbed wooden bench in a narrow tiled pantry, steel bowls stacked on the shelves. 5-10s: she puts the piping bag down, turns the cake once on its plate to check it from every side, and straightens one flower with a fingertip. 10-15s: she lifts the cake on its plate, turns and carries it through the cramped kitchen past hanging ladles and a steaming stockpot, the camera following at shoulder height. 15-20s: she shoulders open a back door into a quiet, sunlit courtyard and walks across the flagstones. 20-25s: she sets the cake down on a weathered table laid for one and steps back to look at it. 25-30s: she wipes her hands on the apron and walks back inside, leaving the cake alone on the table in the sun. Sound: piping bag squeeze, a pot lid rattling, the door creak, birds outside.”Kling 4.0, 30 s, con audio, 1,410 créditos, hecho en Kling AI
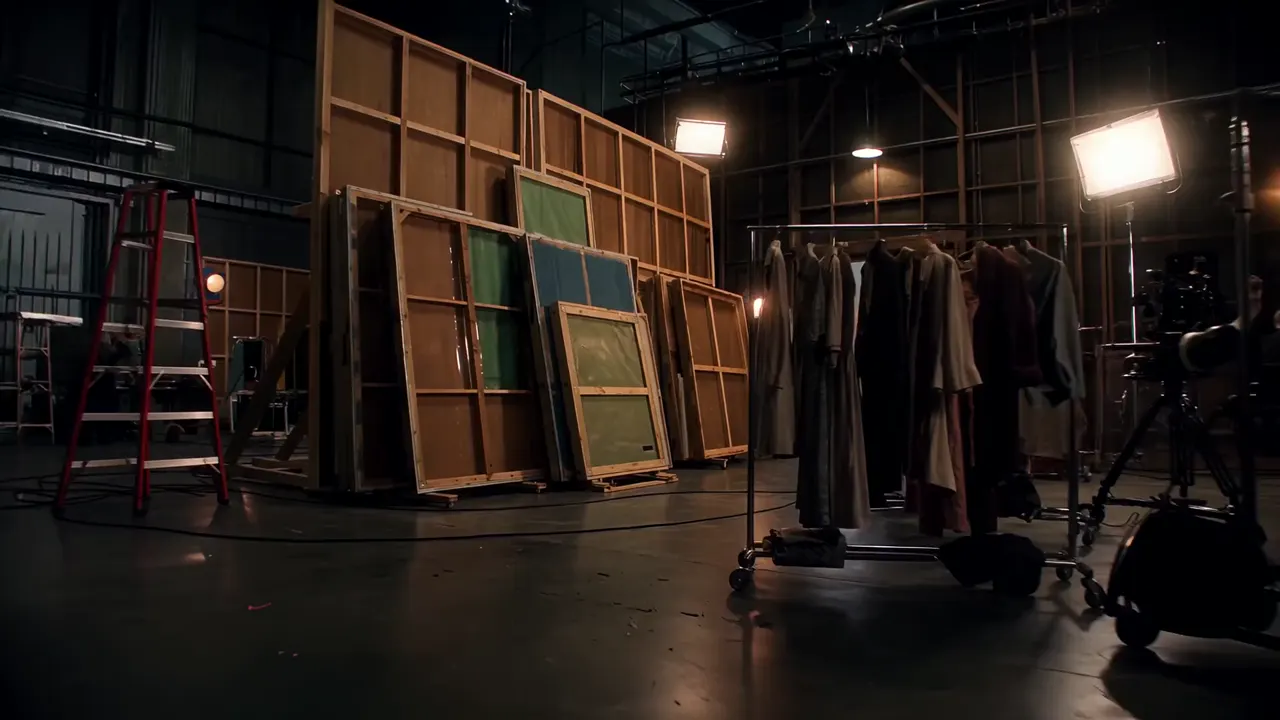
Set de cine de noche, una sola toma de 30 segundos
“One unbroken thirty-second Steadicam move through a working film studio backlot at two in the morning. No cuts anywhere in the take. 0 to 6s: the camera walks out of a scene dock past stacked flats and a rail of period costume, catching a grip taping down a cable run, then pushes through hanging plastic sheeting into open air. 6 to 14s: it crosses a New York street standing set with the rain machines at full pressure, water sheeting off fire escapes and pooling in the gutters, a stunt performer in a soaked overcoat waiting on her mark while a focus puller measures to her face. 14 to 22s: it turns left down a service alley between two sound stages, past a catering truck with its shutter half down and an electrician asleep in a folding chair, the rain noise falling away behind the wall. 22 to 30s: it comes out onto the lot road, cranes up over a parked camera truck and holds on the whole backlot under sodium light, rain still falling on one street and nowhere else. Anamorphic, sodium and mercury practicals, deep blacks, fine film grain. Sound: rain machines roaring then dropping off, a radio crackle, boots on wet asphalt, a generator running under everything, no music.”Wan 3.0, 30 s, con audio, 1,200 créditos, hecho en Wan
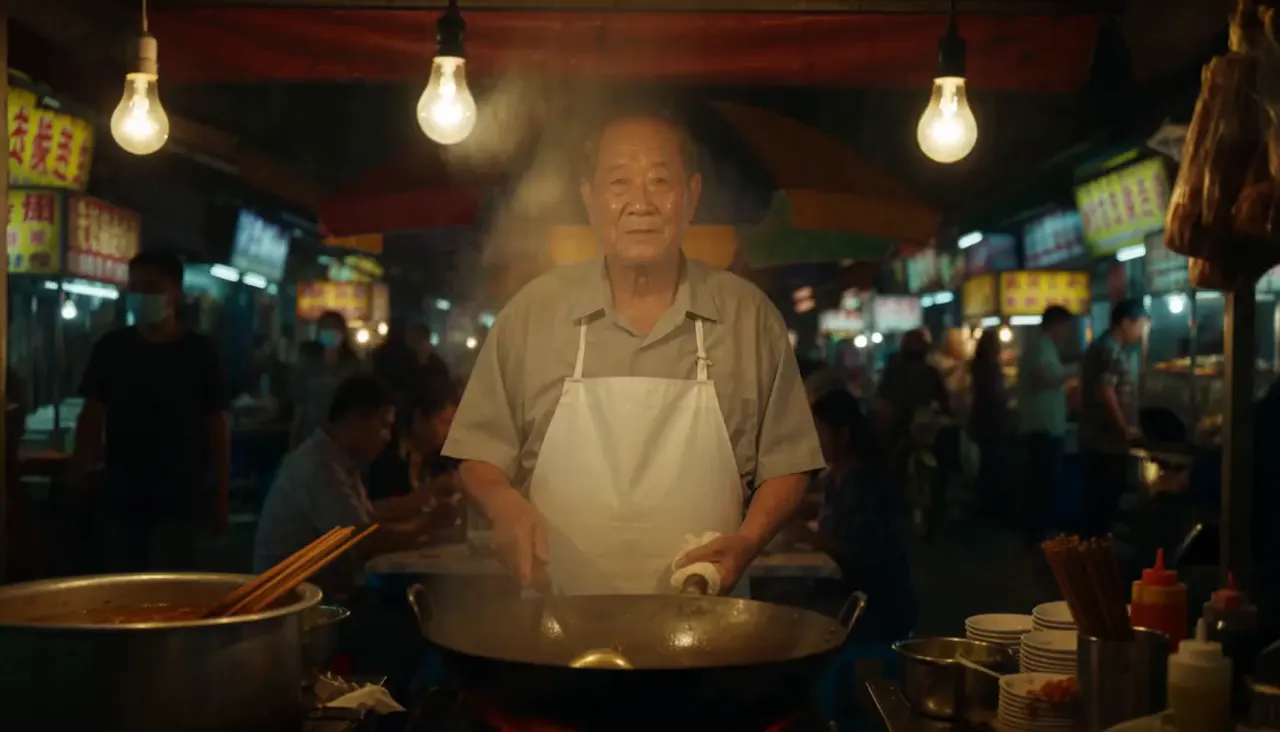
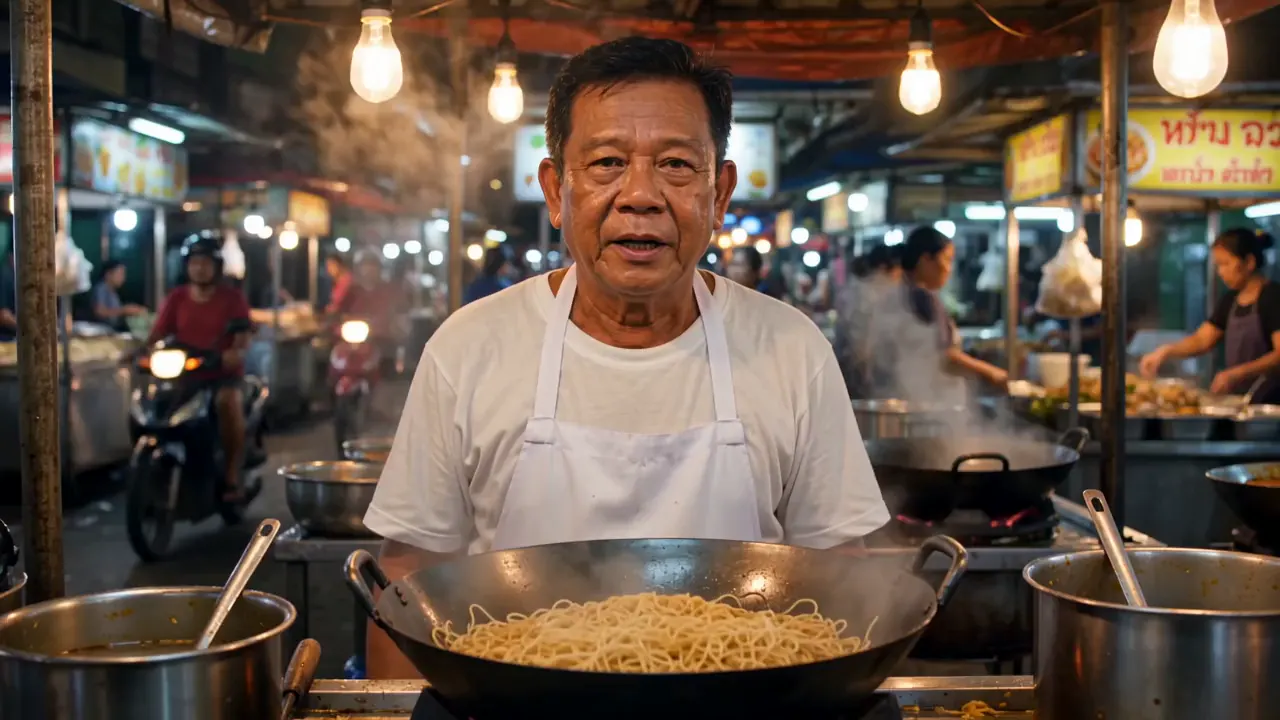
Puesto de fideos: una frase y luego llamas
“Medium close-up, 50mm. A night-market noodle vendor in a white apron stands behind a steaming wok under bare hanging bulbs. He looks into the camera and says: "Thirty years. Same pan, same recipe." Then he tosses the noodles high and flames jump up from the wok. Camera: gentle living handheld that barely breathes, slight push-in. Audio: his voice, sizzling oil, crowd chatter, distant scooters. Photorealistic, warm practical light.”MiniMax H3, 10 s, con audio, 80 créditos
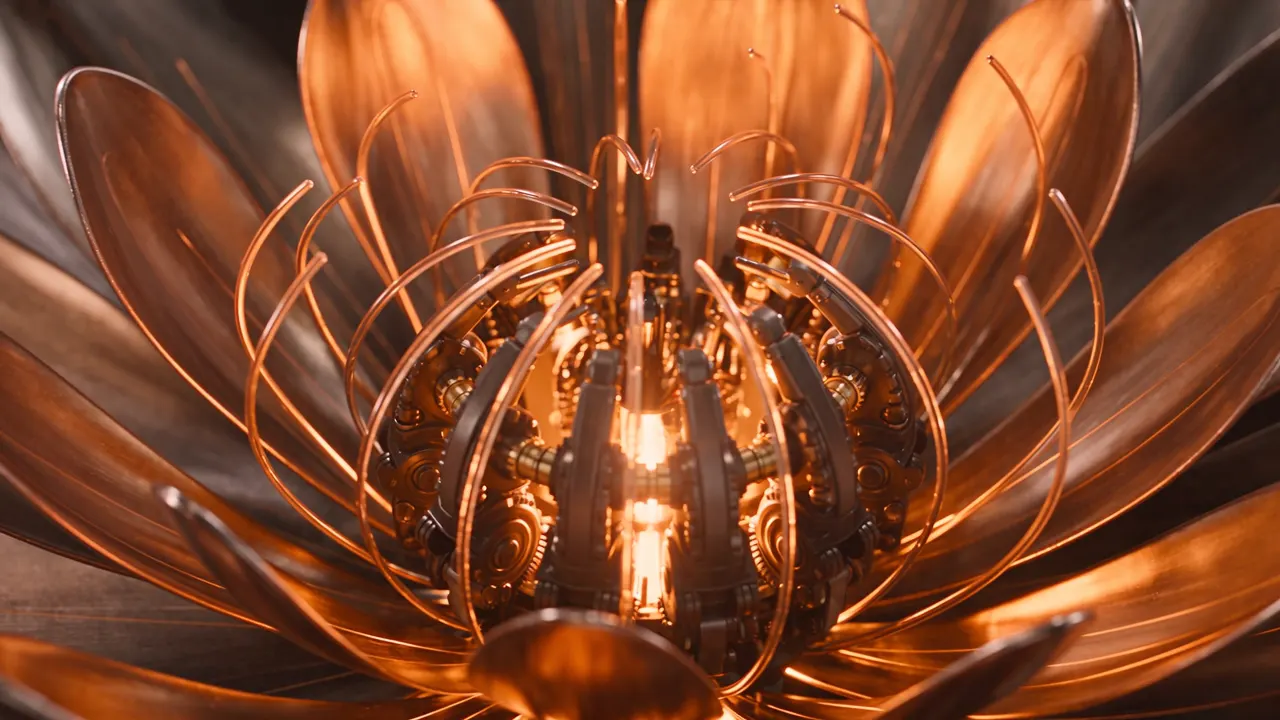
Anuncio con una flor mecánica
“The theme is "mechanical flower bloom". The image needs to highlight the generative video model's strengths in lighting and shadow, art detail, realism, camera movement, and cinematic character feel. The overall style is a high-end tech-brand ad with strong visual impact. The video uses a single-take macro push-in shot, starting from a metal flower bud in darkness, gradually entering the precision mechanical structure inside the petals, and finally climaxing on the image of the mechanical flower fully blooming with light radiating outward. It requires realistic physical lighting, refined metal and glass materials, delicate mechanical motion, stable composition, cinematic color grading, no subtitles.”Seedance 2.5, 15 s, con audio, 890 créditos, hecho en Dreamina
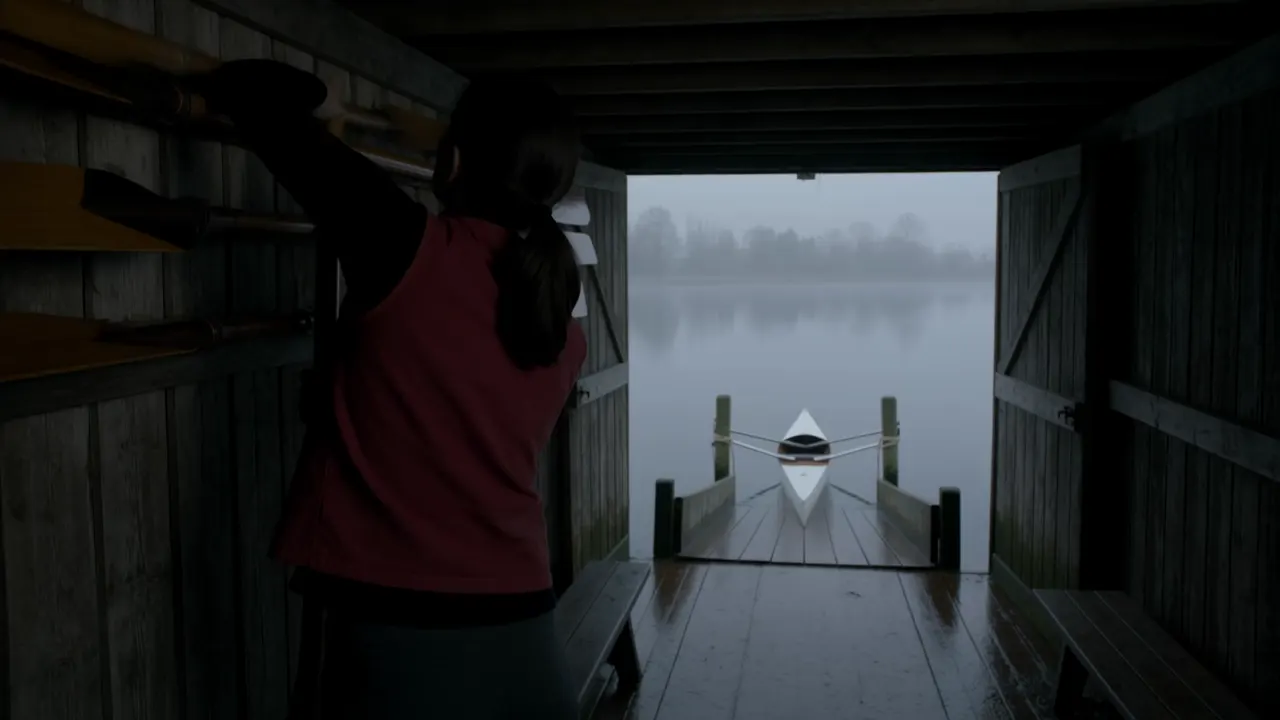
Remo al amanecer, una sola toma de 15 segundos
“One unbroken handheld take on 16mm film, misty grey dawn, a muted palette of wet timber, slate water and fog with one faded-red accent. 0-4s: inside an old timber boathouse on a still lake, a young woman in a faded red rowing vest and grey leggings lifts a pair of long wooden oars down from a wall rack. 4-8s: she carries the oars on her shoulder down the wet wooden slipway, the camera following behind her at shoulder height. 8-12s: she steps carefully into a narrow white single scull tied at the jetty, sits, and slots the oars into their riggers. 12-15s: she pushes off from the jetty with one hand and takes her first stroke, the scull gliding out into the fog, ripples spreading toward the camera. Sound: creaking boards, her footsteps, water lapping, one distant bird call.”Kling 4.0, 15 s, con audio, 705 créditos, hecho en Kling AI
Puesto de fideos: una frase y luego llamas
“Medium close-up, 50mm. A night-market noodle vendor in a white apron stands behind a steaming wok under bare hanging bulbs. He looks into the camera and says: "Thirty years. Same pan, same recipe." Then he tosses the noodles high and flames jump up from the wok. Camera: gentle living handheld that barely breathes, slight push-in. Audio: his voice, sizzling oil, crowd chatter, distant scooters. Photorealistic, warm practical light.”Wan 3.0, 8 s, con audio, 160 créditos, hecho en Wan
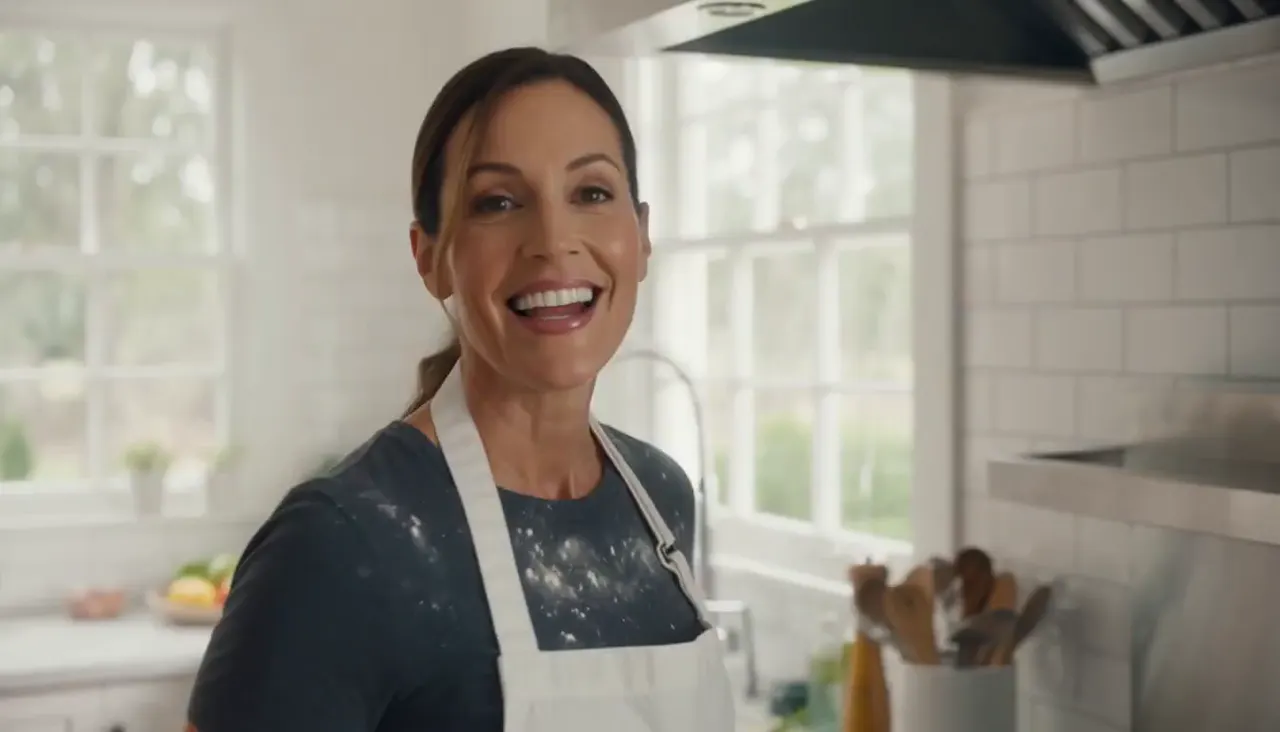
Chef, una frase a cámara
“A chef in her forties looks straight into the camera in a bright open kitchen and says, "The secret is you never crowd the pan." She smiles and turns back to the stove. Clean daylight from a window, white tile, flour on her apron, a strand of hair loose. Medium close-up, 50mm, slight handheld. Sound: her voice close and clear, a gentle sizzle, a knife on a board off screen.”MiniMax H3, 5 s, con audio, 40 créditos
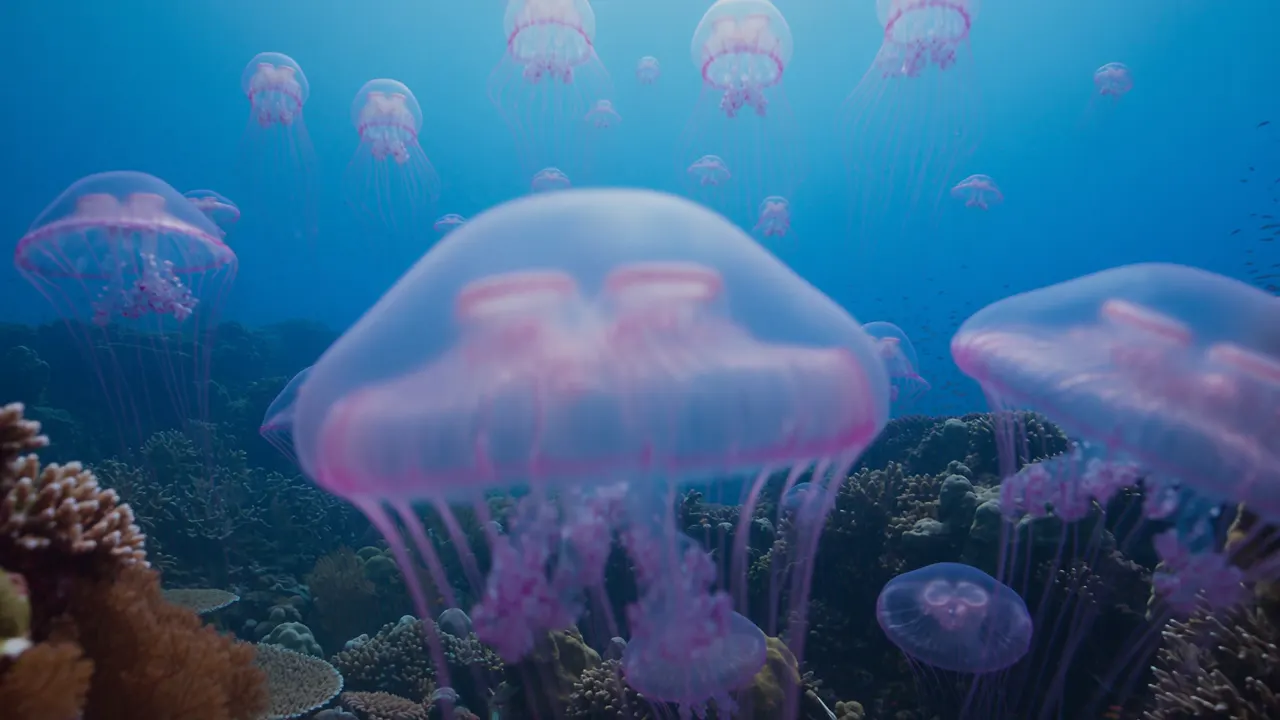
Medusas en un arrecife de coral
“A deep-sea coral-reef scene, a blue-toned tropical underwater world with large expanses of healthy, thriving colorful living coral, including branching coral, brain coral, plate coral, and soft sea-fan coral, with large schools of tropical fish weaving naturally among them. The foreground is crisp and vivid; the distance gradually turns bluer and grayer with reduced contrast. Natural light from above is filtered through the seawater into soft volumetric light, with fine suspended particles and a gentle sense of flow in the water, the soft corals swaying lightly and the fish schools moving smoothly and in coordination. Add a group of semi-transparent pale-lavender glowing jellyfish slowly appearing, 8-12 of them, in varying sizes. Their bell bodies carry a soft bioluminescent effect, tentacles drifting gently with the current, the tentacle tips bearing faint purple light points. The jellyfish are proportioned harmoniously with the corals and fish, the glow soft and not harsh, forming dreamy light spots against the dark seawater background. The jellyfish swarm's movement path is natural, rising in a slow ascending spiral, with some jellyfish swimming past in front of the lens to produce a slight lens-flare effect. Maintain the underwater blue-toned lighting, the jellyfish glow coexisting harmoniously with the faint reflections of the surrounding coral.”Seedance 2.5, 10 s, con audio, 595 créditos, hecho en Dreamina
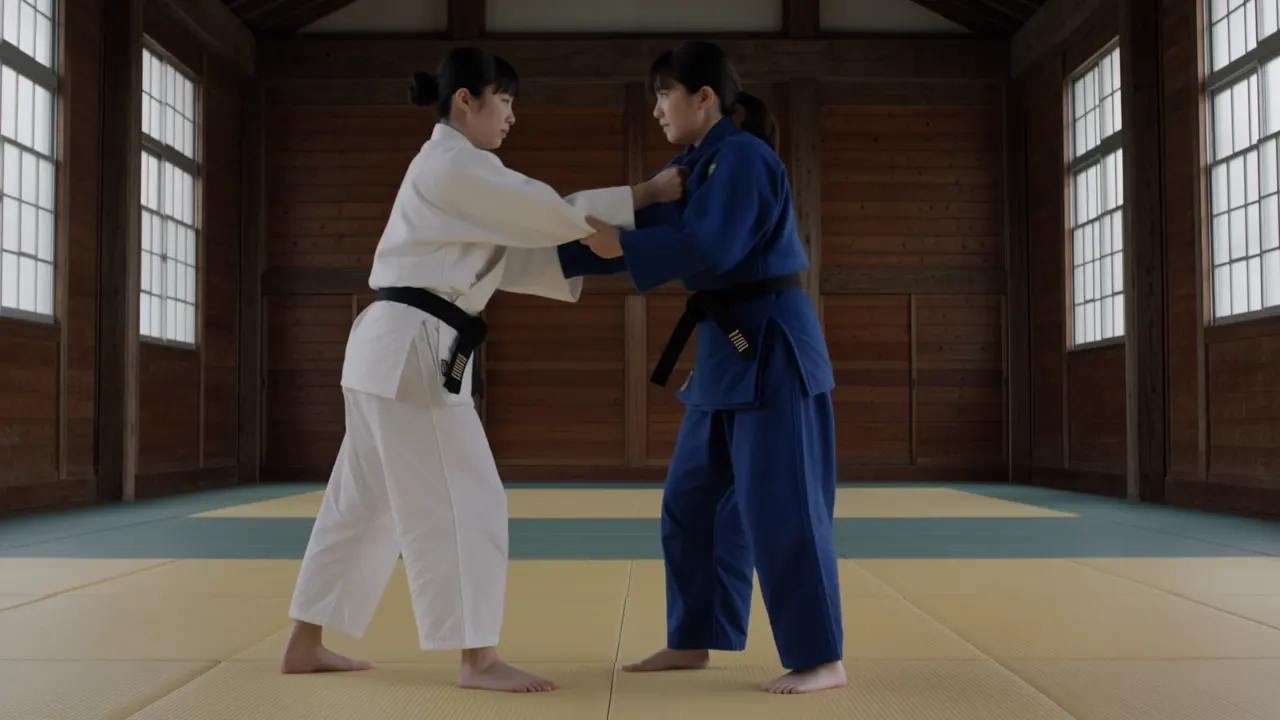
Proyección de cadera en judo
“Real-time speed, 35mm documentary look, flat daylight from tall paper windows in an old wooden dojo with straw-yellow tatami. Two women judoka, one in a white judogi and one in a deep blue judogi, grip each other's lapels and sleeves. The woman in white steps in, turns her hip under her opponent and throws her in a clean hip throw; the woman in blue rotates over her hip through the air, lands flat on her back with a loud slap of the mat and immediately rolls up to her knees. Camera: low handheld, side-on, following the throw. Sound: bare feet on tatami, a sharp exhale, the slap of the landing.”Kling 4.0, 5 s, con audio, 235 créditos, hecho en Kling AI
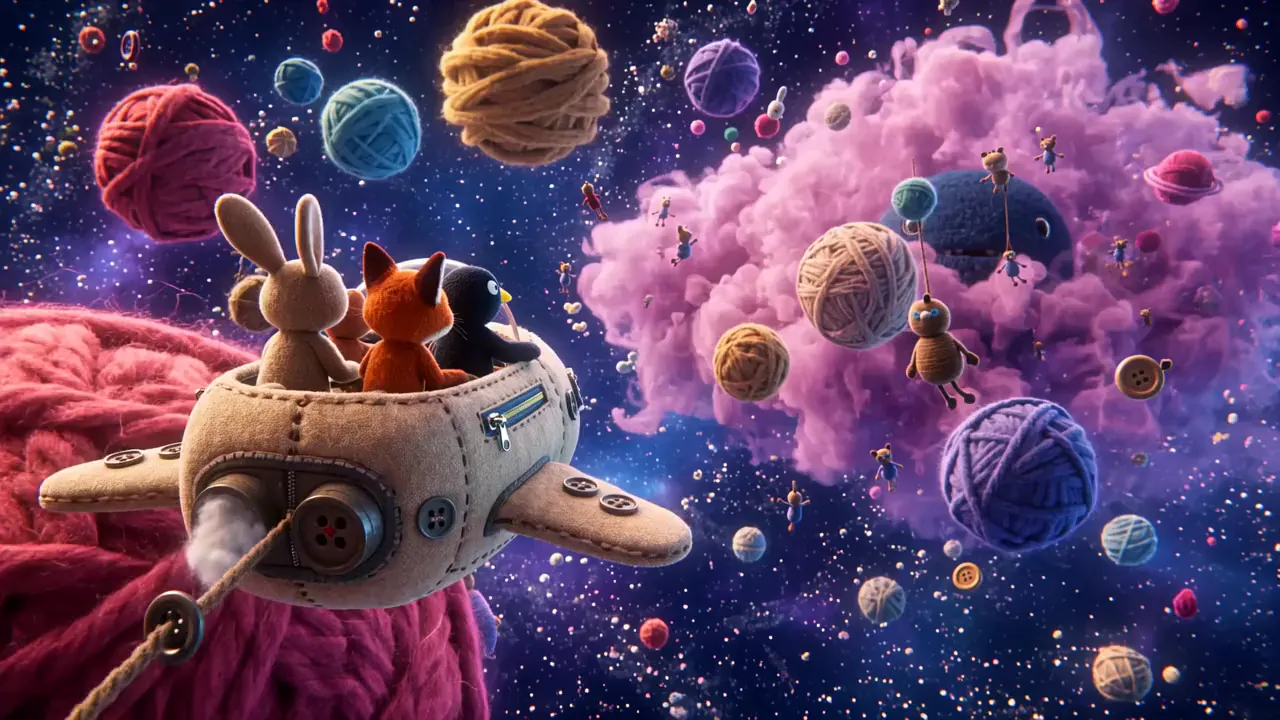
Persecución espacial de peluche
“A 20-second ultra-widescreen plush universe adventure clip, featuring ultra-fine plush textures throughout, cinematic space scale, a contrast between cute appearances and intense action, exaggerated FPV camera movements, and realistic soft-body physics. A spaceship made of plush fabric, buttons, zippers, and stuffing cotton carries three small plush animals — a rabbit, a fox, and a crow — fleeing at high speed through a universe composed of giant yarn planets, fluffy nebulae, and puppet giant beasts. A massive interstellar whale beast covered in deep blue long fur with eyes like two glass buttons chases the ship from within the nebula. The dynamics include the zipper ship launching via catapult, high-speed orbiting around a yarn planet, the giant whale bursting out from behind, navigating through a button asteroid belt, being swallowed by the whale beast, escaping through a golden zipper on its back, the whale slowly deflating as if losing its stuffing cotton, and finally flying through a pink-purple fluffy nebula toward a colorful button sun.”Wan 3.0, 20 s, con audio, 400 créditos, hecho en Wan
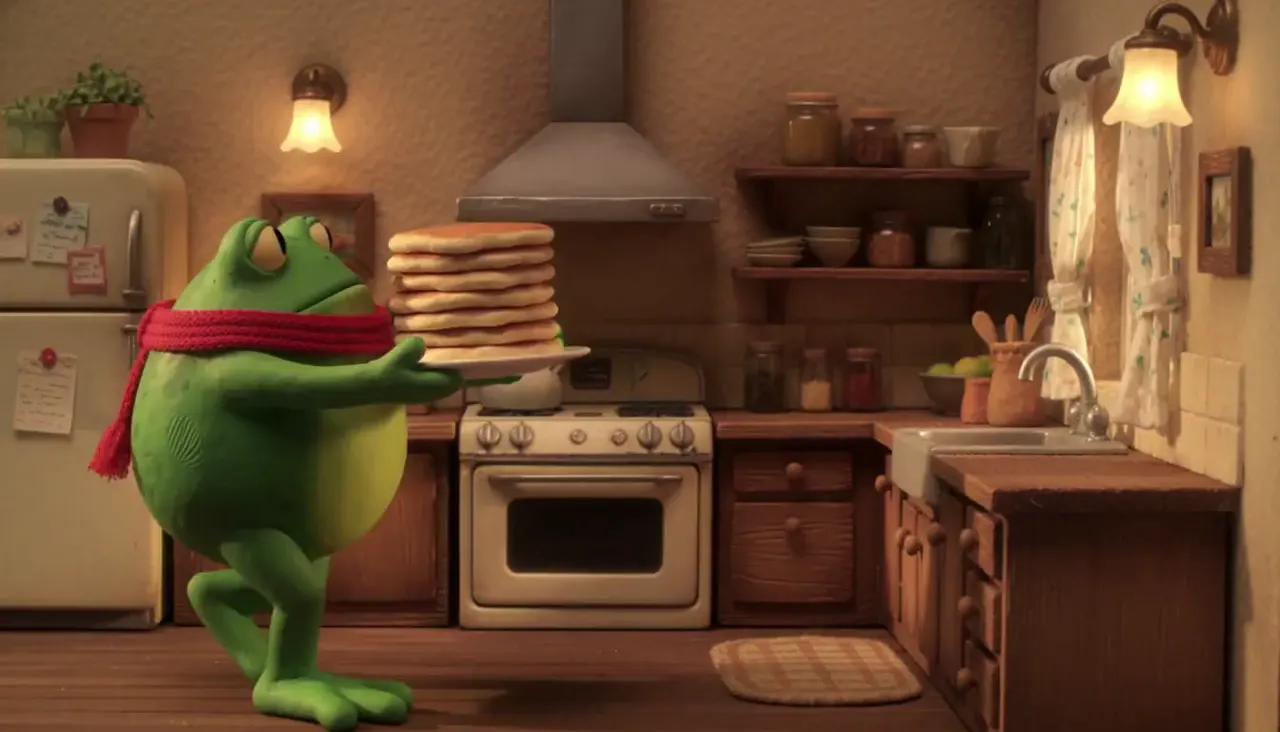
Rana de plastilina
“Stop-motion claymation: a round green frog in a knitted scarf carries a stack of pancakes across a tiny kitchen set, sets it down, then looks at camera and blinks. Visible fingerprints in the clay, felt walls, warm practical lamps, stepped 12fps motion. Sound: playful pizzicato strings, soft clay squeaks, a plate clink.”MiniMax H3, 5 s, con audio, 40 créditos

Cómo convertir texto en video

  1. 1

    Elige un modelo

    Al principio está seleccionado Seedance 2.5. Cambia a Wan 3.0 o Kling 4.0 (Kling AI) para tomas de hasta 30 segundos, o a MiniMax H3 (Hailuo AI) para borradores rápidos y económicos. La tabla de abajo muestra qué hace y cuánto cuesta cada uno.

  2. 2

    Describe la toma

    Escribe primero qué hace la cámara, luego quién aparece en el cuadro, qué hace y qué se oye. Pon entre comillas lo que se dice. Más abajo, la guía de prompts tiene los detalles.

  3. 3

    Elige duración, formato y audio

    Elige la duración del clip, la resolución, la relación de aspecto (vertical 9:16 para Reels, TikTok y Shorts) y si lleva audio. El precio se actualiza con cada cambio, antes de que gastes nada.

  4. 4

    Genera y ajusta

    La mayoría de los clips están listos en unos minutos y se quedan en tu historial. Prueba la redacción con un clip corto o en baja resolución y luego genera en calidad completa la versión que te guste.

Modelos disponibles y precios

Actualizado el 30 de octubre de 2026

ModeloDuraciónResolución máximaAudioRelación de aspectoClip de 5 sClip de 10 sPuesto en la arena
Seedance 2.54–15s1080pSí16:9, 9:16, 1:1, 4:3, 3:4, 21:9300 créditosUSD 3.00595 créditosUSD 5.95Puesto 4 · Elo 1,157Dreamina Seedance 2.5
Kling 4.05–30s1080pSí16:9, 9:16, 1:1, 21:9160 créditosUSD 1.60315 créditosUSD 3.15Aún sin clasificar
Wan 3.05–30s1080pSí16:9, 9:16, 1:1, 4:3, 3:4100 créditosUSD 1.00200 créditosUSD 2.00Puesto 1 · Elo 1,175
MiniMax H35–15s2KSí16:9, 9:16, 1:1, 4:3, 3:4, 21:940 créditosUSD 0.4080 créditosUSD 0.80Puesto 3 · Elo 1,161MiniMax H3 (768p)

Los precios de los clips son a 720p con audio (MiniMax H3: 768p), en la versión más económica de cada modelo; las resoluciones más altas cuestan más. El puesto en la arena es la posición y la puntuación Elo que resultan de votaciones a ciegas entre pares (AA-Video-T2V v2.1, with audio, revisado el 30 de octubre de 2026) en la Artificial Analysis Text to Video Arena

Ejemplos de texto a video, con su prompt

Cada ejemplo incluye su prompt exacto, su configuración y su precio. Úsalo tal cual en el generador de arriba o edítalo primero.

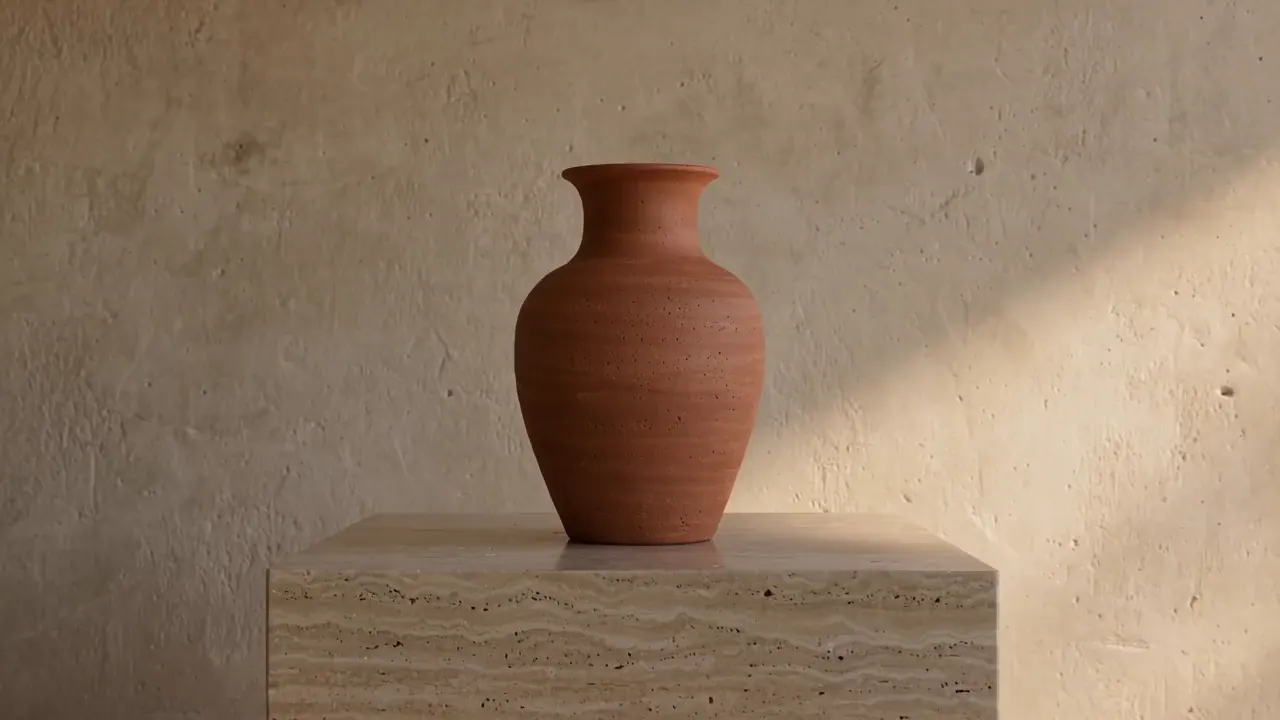
La cámara se acerca a un jarrón de terracota
hecho en Wan

Wan 3.0

Un producto en un solo movimiento

Un acercamiento lento a un jarrón en una habitación con sol, en una sola toma. El prompt viene de la prueba “Wan 3.0 vs Seedance 2.5” de Fuser.

  • Texto a video
  • 720p
  • 5 s
  • con audio
  • 16:9

“Slow dolly-in on a matte terracotta vase standing on a travertine plinth in a sunlit plaster room. Late-afternoon light slides slowly across the wall as dust drifts through the beam. Calm, premium product film, shallow depth of field. Audio: soft room tone and a faint breeze.”

Consejo: Un movimiento de cámara por clip, con su velocidad: “slow dolly-in”.

100 créditos
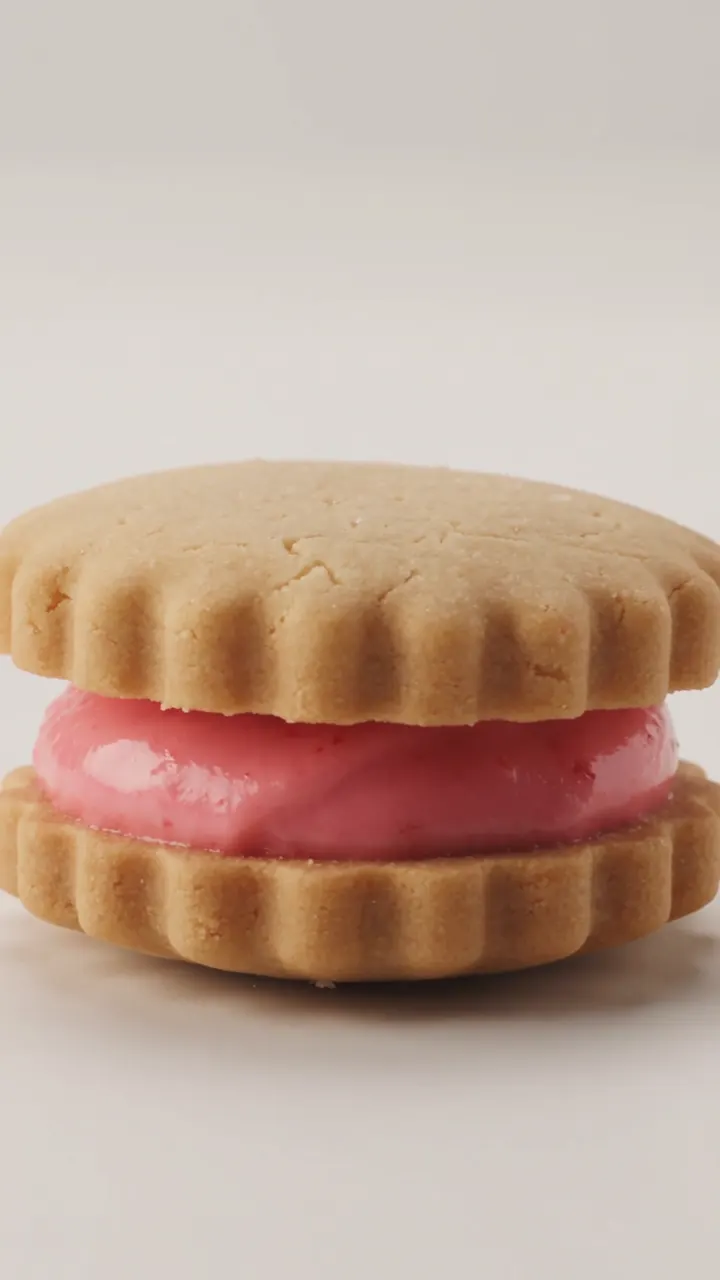
Galleta girando, video vertical
hecho en Dreamina

Seedance 2.5

Un anuncio vertical para redes

En 9:16, Seedance 2.5 genera un cuadro vertical de verdad, no un recorte de uno horizontal, y le agrega el audio. El prompt de una sola frase es del tutorial de la propia ByteDance.

  • Texto a video
  • 720p
  • 6 s
  • con audio
  • 9:16

“A strawberry sandwich cookie slowly completes one full rotation while the camera moves smoothly around it and keeps the product centered.”

Consejo: Deja el sujeto en el centro del cuadro, donde los subtítulos y los botones de la app no lo tapen.

360 créditos
Chef, una frase a cámara

MiniMax H3

Una frase dicha a cámara

Ella mira al lente y dice la frase tal como está escrita, con el sonido de la cocina alrededor, en la versión rápida H3 Max Turbo.

  • Texto a video
  • 768p
  • 5 s
  • con audio
  • 16:9

“A chef in her forties looks straight into the camera in a bright open kitchen and says, "The secret is you never crowd the pan." She smiles and turns back to the stove. Clean daylight from a window, white tile, flour on her apron, a strand of hair loose. Medium close-up, 50mm, slight handheld. Sound: her voice close and clear, a gentle sizzle, a knife on a board off screen.”

Consejo: Pon las palabras entre comillas y di quién habla y cómo: “looks straight into the camera … and says, “…””.

40 créditos
Pastelera, una sola toma de 30 segundos
hecho en Kling AI

Kling 4.0

Una toma de 30 segundos

Seis momentos con tiempo marcado en una sola toma continua, cada uno en su intervalo. El prompt es de la guía de Kling 4 de Fuser. Igual que en la prueba de Fuser, salió con luz de día suave en lugar del flash directo que pide el prompt.

  • Texto a video
  • 1080p
  • 30 s
  • con audio
  • 16:9

“One unbroken handheld take, direct-flash 35mm snapshot look, fine grain, white tile and bright window light. 0-5s: from behind, a young pastry cook in a white jacket and a long black apron pipes the last pale-yellow buttercream flowers onto a small white cake on a scrubbed wooden bench in a narrow tiled pantry, steel bowls stacked on the shelves. 5-10s: she puts the piping bag down, turns the cake once on its plate to check it from every side, and straightens one flower with a fingertip. 10-15s: she lifts the cake on its plate, turns and carries it through the cramped kitchen past hanging ladles and a steaming stockpot, the camera following at shoulder height. 15-20s: she shoulders open a back door into a quiet, sunlit courtyard and walks across the flagstones. 20-25s: she sets the cake down on a weathered table laid for one and steps back to look at it. 25-30s: she wipes her hands on the apron and walks back inside, leaving the cake alone on the table in the sun. Sound: piping bag squeeze, a pot lid rattling, the door creak, birds outside.”

Consejo: Empieza con “One unbroken take” y dale a cada tramo de cinco segundos su propio momento (“0-5s: …, 5-10s: …”).

1,410 créditos
Proyección de cadera en judo
hecho en Kling AI

Kling 4.0

Acción rápida entre dos personas

Una proyección de cadera limpia: cada brazo y cada pierna se quedan en la persona correcta, y el golpe de la caída se oye en el audio. La cámara se queda fija en vez del movimiento bajo, cámara en mano, que pide el prompt.

  • Texto a video
  • 1080p
  • 5 s
  • con audio
  • 16:9

“Real-time speed, 35mm documentary look, flat daylight from tall paper windows in an old wooden dojo with straw-yellow tatami. Two women judoka, one in a white judogi and one in a deep blue judogi, grip each other's lapels and sleeves. The woman in white steps in, turns her hip under her opponent and throws her in a clean hip throw; the woman in blue rotates over her hip through the air, lands flat on her back with a loud slap of the mat and immediately rolls up to her knees. Camera: low handheld, side-on, following the throw. Sound: bare feet on tatami, a sharp exhale, the slap of the landing.”

Consejo: Identifica quién hace qué por su ropa (“the woman in white … the woman in blue”) para que el modelo no las confunda.

235 créditos
Anuncio con una flor mecánica
hecho en Dreamina

Seedance 2.5

Un video de marca de alta gama

La luz sobre metal y vidrio es donde Seedance 2.5 es más fuerte. El prompt nombra el estilo, un solo acercamiento macro y los materiales, y el clip lo sigue desde un capullo oscuro hasta la flor que se abre llena de luz.

  • Texto a video
  • 720p
  • 15 s
  • con audio
  • 16:9

“The theme is "mechanical flower bloom". The image needs to highlight the generative video model's strengths in lighting and shadow, art detail, realism, camera movement, and cinematic character feel. The overall style is a high-end tech-brand ad with strong visual impact. The video uses a single-take macro push-in shot, starting from a metal flower bud in darkness, gradually entering the precision mechanical structure inside the petals, and finally climaxing on the image of the mechanical flower fully blooming with light radiating outward. It requires realistic physical lighting, refined metal and glass materials, delicate mechanical motion, stable composition, cinematic color grading, no subtitles.”

Consejo: Usa la misma estructura para tu producto: estilo, una toma, materiales, “no subtitles”.

890 créditos
Puesto de fideos: una frase y luego llamas
hecho en Wan

Wan 3.0

Una frase y luego el gran momento

Dice la frase tal como está escrita y después el wok se llena de llamas. El prompt es de la prueba “Seedance 2.5 vs Wan 3.0” de Krea, donde Wan 3.0 también logró las llamas y Seedance no. Los letreros detrás de él son escritura inventada.

  • Texto a video
  • 720p
  • 8 s
  • con audio
  • 16:9

“Medium close-up, 50mm. A night-market noodle vendor in a white apron stands behind a steaming wok under bare hanging bulbs. He looks into the camera and says: "Thirty years. Same pan, same recipe." Then he tosses the noodles high and flames jump up from the wok. Camera: gentle living handheld that barely breathes, slight push-in. Audio: his voice, sizzling oil, crowd chatter, distant scooters. Photorealistic, warm practical light.”

Consejo: Pon la frase al principio y la acción grande después (“first …, only then …”).

160 créditos
Rana de plastilina

MiniMax H3

Estilo stop-motion

El aspecto de plastilina y el movimiento a saltos se mantienen en todo el clip. Hacia el segundo 4 cortó a un primer plano sin que se lo pidieran.

  • Texto a video
  • 768p
  • 5 s
  • con audio
  • 16:9

“Stop-motion claymation: a round green frog in a knitted scarf carries a stack of pancakes across a tiny kitchen set, sets it down, then looks at camera and blinks. Visible fingerprints in the clay, felt walls, warm practical lamps, stepped 12fps motion. Sound: playful pizzicato strings, soft clay squeaks, a plate clink.”

Consejo: Agrega “one continuous shot” si no quieres cortes.

40 créditos

Cómo escribir un buen prompt para video con IA

Qué poner en el prompt, en el orden en que los modelos lo entienden mejor.

Empieza por la cámara

Abre con el tamaño del plano, el lente o el movimiento de cámara; después, el sujeto, la acción y la luz. Varias guías de prompts usan este orden, y la reescritura de prompts de los modelos respeta mejor el encuadre cuando va primero.

“Medium close-up, 50mm, slow push in. A night-market noodle vendor in a white apron stands behind a steaming wok…”

Una acción por clip, o un tiempo para cada una

Un clip de 5 segundos sostiene bien una acción. En tomas más largas, dale a cada parte su intervalo de tiempo: Fuser midió que los cortes de Wan 3.0 caían a menos de un fotograma de los tiempos escritos, y su guía de Kling 4 sugiere más o menos una acción cada cinco segundos.

“0-5s: she pipes the last flower. 5-10s: she steps back and wipes her hands…”

Escribe “one continuous shot” si no quieres cortes

Kling 4.0 hace clips de varias tomas por defecto y Wan 3.0 a veces corta a otro ángulo a mitad del clip. Las guías de ambos fabricantes lo resuelven igual: dilo en la primera línea.

“One unbroken take, no cuts. The camera follows…”

El diálogo, entre comillas y al principio

Pon entre comillas lo que se dice, indica quién habla y en qué idioma, y coloca la frase al principio del clip para que tenga tiempo de terminar. Una frase escrita para el último segundo suele quedar cortada.

“He looks up and says in English, “Thirty years, same pan, same recipe.” Only then the wok flares.”

Nombra el sonido que quieres y el que no

Todos los modelos de esta página generan audio y, sin indicaciones, eligen el suyo, muchas veces música. La guía de ByteDance deja las instrucciones negativas solo para el sonido y los subtítulos: termina con “No background music” o “No subtitles”.

“Sound: oil hissing, a crowd murmuring, no background music. No subtitles.”

Detalles concretos, no adjetivos

Palabras como “cinematic” o “epic” no le dan al modelo nada a qué agarrarse. Un color, un material, una hora del día y un objeto al fondo, sí. No cuentes con cantidades exactas de cosas ni con que el texto pequeño salga bien escrito.

“A red bicycle leaning on a wet brick wall at dusk, a sodium street lamp flickering behind it.”

¿Qué modelo de texto a video te conviene?

Los cuatro modelos crean clips con audio a partir de un prompt escrito, pero se comportan distinto. Estas notas vienen de pruebas independientes con el mismo prompt hechas por Fuser, Krea y Atlas Cloud, de las guías de prompts de los propios fabricantes y de los ejemplos que generamos nosotros. Los puestos en las clasificaciones y los precios están en la tabla de arriba.

Wan 3.0, el modelo de video con IA de Alibaba, es el que sigue el prompt de forma más literal. En la prueba de Krea dio “the most literal, dramatic version of a prompt” (la versión más literal y dramática del prompt), y en las cinco rondas de Fuser con las mismas entradas captó detalles que Seedance 2.5 pasó por alto. Hace hasta 30 segundos en una sola pasada y cuesta menos por segundo que Seedance 2.5. Sus puntos débiles: a veces corta a otro ángulo a mitad del clip, y su mezcla de audio sale fuerte (Krea, Fuser).

Seedance 2.5, el modelo de video con IA de ByteDance, la empresa dueña de TikTok, da el aspecto más pulido y cinematográfico: la luz sobre metal, vidrio y piel, una mezcla de audio más tranquila y diálogo en más de diez idiomas. Es el más caro de los cuatro por segundo, suaviza las caras en primeros planos a 720p y las acciones rápidas pueden deformarse. La guía de ByteDance aconseja un solo movimiento de cámara por toma (ByteDance).

Kling 4.0 (Kling AI), el modelo de video de Kuaishou, la plataforma china de videos cortos, es el indicado para acción y tomas largas: las tomas continuas de 15 a 30 segundos aguantaron en todas las pruebas, mantuvo cada brazo y pierna en la persona correcta en nuestro lanzamiento de judo y escribió bien nuestro letrero y nuestro subtítulo. Agrega cortes y música si no le dices lo contrario, y se salta algunas palabras de estilo, como el aspecto de una película fotográfica (Fuser).

MiniMax H3, el modelo de video de MiniMax, conocido por la app Hailuo AI, viene aquí en dos versiones. H3 Max Turbo es el clip más rápido y económico de esta página, bueno para probar la redacción antes de gastar más. El H3 oficial agrega 2K. Genera 768p como 1344×768 en lugar de 720p, y reescribe los prompts cortos, lo que puede agregar un corte (Krea).

¿Texto a video o imagen a video?

El texto a video inventa todo a partir de tus palabras: cada imagen se genera desde cero, no se arma con videos de stock ni diapositivas. Por eso dos ejecuciones del mismo prompt dan dos clips distintos. Cuando el producto, el personaje o la composición deben coincidir con algo que ya tienes, empieza mejor desde una imagen: imagen a video usa tu imagen como fotograma inicial. Una forma común de trabajar es crear la imagen fija con el generador de imágenes con IA y después animarla.

Duración, resolución y formato

Elige la duración más corta que alcance para la acción. Un clip de 5 segundos sostiene un movimiento; 10 segundos dan para dos o tres momentos con tiempo marcado; de 20 a 30 segundos sirven para una sola toma larga con Kling 4.0 o Wan 3.0. La resolución es lo que más cambia el precio, y volver a generar en una resolución mayor da una toma nueva, no una versión ampliada de tu borrador, así que usa 720p solo para probar la redacción. Elige la relación de aspecto antes de generar: horizontal (16:9) para YouTube y sitios web, vertical (9:16) para el celular, cuadrado (1:1) para el feed, y 21:9 en Kling 4.0, Seedance 2.5 y MiniMax H3 para un cuadro panorámico de cine.

Lo que pagas

Cada clip tiene un precio en créditos que depende del modelo, la duración, la resolución y el audio, y lo ves antes de generar. Los créditos vienen de paquetes de pago único que no vencen, así que no hay plan mensual que cancelar ni cobros automáticos. Si un clip falla, tarda demasiado o es rechazado, sus créditos vuelven a tu saldo automáticamente.

Cómo hicimos los ejemplos de esta página

Cada ejemplo muestra el prompt, el modelo y la configuración con que se hizo, y su precio actual en zzo.ai. La mayoría de los prompts vienen de pruebas y guías publicadas, citadas en cada tarjeta, para que puedas comparar nuestro resultado con el suyo. Algunos ejemplos se hicieron en la app del propio fabricante del modelo con el mismo modelo, prompt y configuración, y están marcados así. Ningún clip está editado, y cuando un clip no cumplió parte del prompt, la tarjeta lo dice.

Cuando un resultado sale mal

Los problemas habituales, por qué pasan y qué cambiar.

El clip corta a otro ángulo que no pediste

Por qué: Kling 4.0 tiene las tomas múltiples activadas por defecto, y quienes lo probaron vieron a Wan 3.0 cortar a mitad del clip aunque se le pidiera que no.

Solución: Empieza el prompt con “One continuous shot, no cuts” y mantén la acción en un solo lugar. Si aun así corta, genera otra vez o prueba Seedance 2.5.

Hay música que no querías, o el audio está muy fuerte

Por qué: Los modelos llenan el silencio con su propia banda sonora. Pruebas independientes encontraron que Kling 4.0 y Wan 3.0 mezclan el audio más fuerte que Seedance 2.5.

Solución: Describe los sonidos que quieres y termina con “No background music”. Baja el volumen en tu editor, o desactiva el audio en Seedance 2.5 y Wan 3.0.

Las palabras de letreros o etiquetas salen mal escritas

Por qué: El texto dentro de la imagen sigue siendo difícil para los modelos de video; ByteDance y Alibaba lo dicen en sus propias notas.

Solución: Usa textos cortos y entre comillas, o agrega los títulos en un editor. Kling 4.0 escribió bien nuestro letrero y nuestro subtítulo.

El movimiento rápido deforma manos, extremidades u objetos

Por qué: Los movimientos rápidos y amplios son lo más difícil para todos los modelos; la guía de ByteDance recomienda un movimiento lento y continuo.

Solución: Haz la acción más lenta o describe un movimiento a la vez. Para peleas, deportes y baile, Kling 4.0 fue el que mejor salió en pruebas independientes.

La frase de diálogo queda cortada

Por qué: Una frase escrita para el final del clip no tiene tiempo de terminar.

Solución: Mueve la frase al principio, acórtala o elige un clip más largo.

El clip fue rechazado o falló

Por qué: El filtro del propio modelo o nuestra revisión de contenido bloqueó el prompt o el resultado, o el modelo tardó demasiado. En Seedance 2.5, los nombres de marcas, de películas fotográficas (film stock) y de directores también pueden provocar un rechazo.

Solución: No se cobra nada: los créditos vuelven automáticamente. Reescribe el prompt sin nombres de personas reales ni de marcas, y revisa la Política de uso aceptable.

Preguntas frecuentes

Actualizado el 30 de octubre de 2026

¿Cuál es la mejor IA para convertir texto en video?

Depende del trabajo. En la clasificación de texto a video de Artificial Analysis, hecha con votos a ciegas entre dos videos lado a lado, Wan 3.0 está en primer lugar, con MiniMax H3 y Seedance 2.5 muy cerca (los puestos y la fecha en que los revisamos están arriba en esta página). Kling 4.0 todavía no aparece en esa clasificación; en pruebas independientes destacó en acción rápida y en tomas largas continuas.

¿Con qué modelo empiezo?

Con Seedance 2.5 para anuncios pulidos y clips con diálogo; con Wan 3.0 para seguir el prompt al pie de la letra y para tomas largas a menor precio; con Kling 4.0 para acción entre personas y texto en pantalla; y con MiniMax H3 (H3 Max Turbo) para borradores rápidos y económicos.

¿Cuánto cuesta crear un video con IA a partir de texto?

Depende del modelo, la duración, la resolución y el audio. La tabla de esta página muestra el precio de 5 y de 10 segundos en cada modelo, y el generador te muestra el precio exacto antes de empezar. Pagas cada clip con créditos; no hay suscripción.

¿De cuántos segundos puede ser el video?

Hasta 30 segundos en una sola toma con Kling 4.0 y Wan 3.0, y hasta 15 segundos con Seedance 2.5 y MiniMax H3. Para algo más largo, haz un clip por toma y únelos en un editor.

¿El video sale con audio, voz y música?

Sí. Todos los modelos de esta página generan el audio junto con la imagen. Escribe en el prompt los sonidos y las frases que se dicen. En Seedance 2.5 y Wan 3.0 puedes desactivar el audio; Kling 4.0 y MiniMax H3 siempre lo incluyen.

¿Puedo escribir el prompt en español? ¿Los personajes pueden hablar en español?

Puedes escribir el prompt en español, pero no lo hemos probado a fondo en cada modelo, y los prompts en inglés suelen dar resultados más estables. Para diálogos: según la información oficial de cada modelo, Kling 4.0 genera diálogo en nueve idiomas y MiniMax H3 en once, y el español está en las dos listas. Diálogos en español con Seedance 2.5 y Wan 3.0 no los hemos probado. Pon la frase entre comillas y di en qué idioma se dice (“says in Spanish, …”).

¿Puedo hacer videos verticales para TikTok, Reels o Shorts?

Sí. Elige 9:16 en el generador. Los cuatro modelos lo ofrecen en texto a video, y la tabla muestra todas las relaciones de aspecto de cada uno.

¿La IA puede poner texto o subtítulos en el video?

A veces. Kling 4.0 escribió bien el letrero y el subtítulo de nuestro ejemplo (en inglés), y MiniMax dice que H3 genera texto con precisión; Seedance 2.5 y Wan 3.0 suelen escribir mal el texto dentro de la imagen. Si algo tiene que leerse exacto, agrégalo en un editor.

¿Por qué mi clip cortó a otra toma?

Algunos modelos agregan cortes por su cuenta, sobre todo Kling 4.0 y Wan 3.0. Empieza el prompt con “One continuous shot, no cuts” para pedir una sola toma.

¿Cuánto tarda en generarse un video?

Normalmente de uno a cinco minutos; las tomas largas en 1080p pueden tardar diez minutos o más. Los clips terminados se quedan en tu historial, donde puedes descargarlos.

¿Qué pasa si una generación falla o es bloqueada?

Los créditos de ese clip vuelven a tu saldo automáticamente, ya sea que el modelo haya fallado, tardado demasiado o rechazado el prompt, o que nuestra revisión de contenido haya bloqueado el resultado. Solo pagas por los clips que recibes.

¿Puedo hacer un video de una persona real o de un famoso?

De figuras públicas no, y de nadie sin su consentimiento. Los personajes ficticios que describes en el prompt sí. La Política de uso aceptable explica lo que no está permitido.

¿Puedo usar los videos con fines comerciales?

Sí. Puedes usar los clips que generas, también en anuncios y trabajos para clientes, siempre que respeten nuestros términos y no copien la marca, el personaje o la imagen de otra persona.

¿Necesito una suscripción?

No. zzo.ai solo vende paquetes de créditos de pago único: no se renuevan automáticamente y no hay nada que cancelar. Tus créditos no vencen y sirven para todos los modelos, en el sitio web y a través de la API.

¿Uso texto a video o imagen a video?

Usa texto a video cuando partes de una idea. Usa imagen a video cuando el aspecto, el producto o el personaje tienen que coincidir con una imagen que ya tienes: el clip empieza en tu imagen.

Más herramientas