Qual modelo de texto para vídeo usar?
Os quatro modelos criam vídeos com som a partir de um prompt escrito, mas se comportam de formas diferentes. As notas abaixo vêm de testes independentes com o mesmo prompt feitos pela Fuser, pela Krea e pela Atlas Cloud, dos guias de prompt dos próprios fabricantes e dos exemplos que nós mesmos geramos. Posições no ranking e preços estão na tabela acima.
Wan 3.0 (da Alibaba) é o que segue o prompt de forma mais literal. No teste da Krea, ele entregou “the most literal, dramatic version of a prompt”, e nas cinco rodadas da Fuser com as mesmas entradas pegou detalhes que o Seedance 2.5 deixou passar. Gera até 30 segundos de uma vez e custa menos por segundo que o Seedance 2.5. Pontos fracos: às vezes corta para outro ângulo no meio do vídeo, e a mixagem de som sai alta (Krea, Fuser).
Seedance 2.5 (da ByteDance, dona do TikTok) tem o visual mais polido, com cara de cinema: luz sobre metal, vidro e pele, uma mixagem mais discreta e falas em mais de dez idiomas. É o mais caro dos quatro por segundo, suaviza rostos em close a 720p, e ações rápidas podem deformar. O guia da ByteDance recomenda um movimento de câmera por tomada (ByteDance).
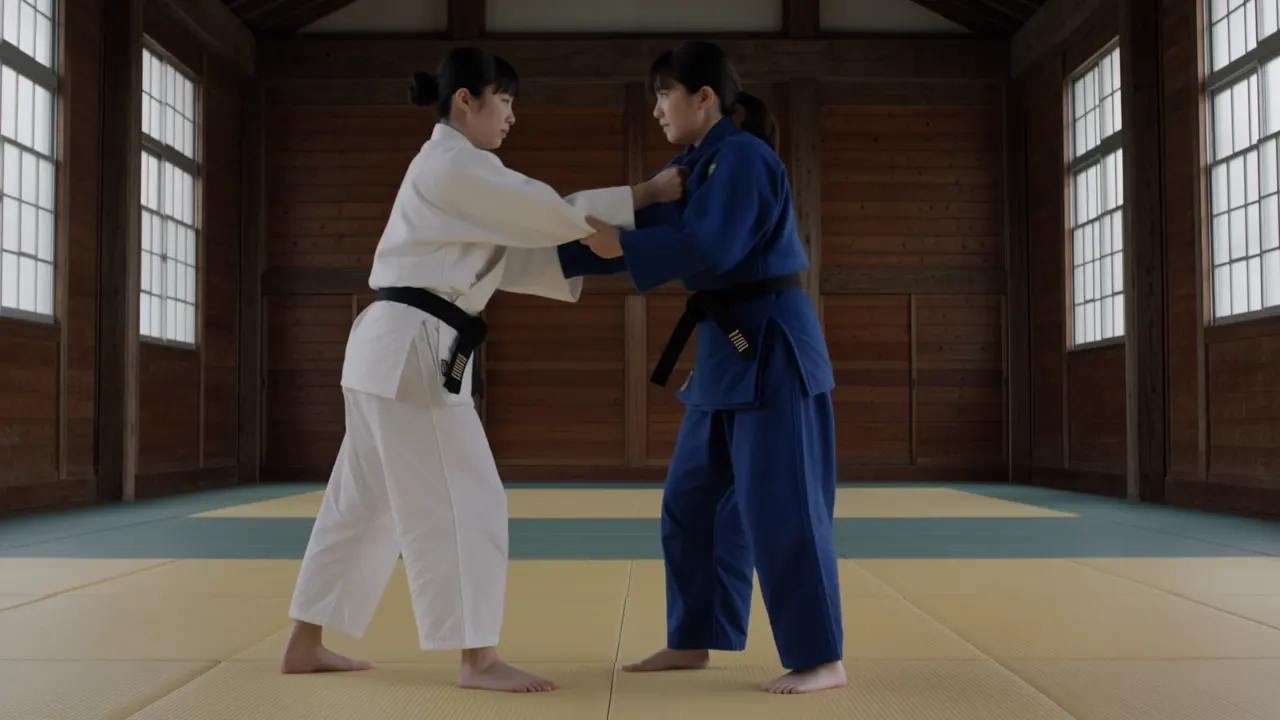
Kling 4.0 é o modelo para ação e tomadas longas: as tomadas únicas de 15 a 30 segundos de todos os testadores se mantiveram, ele deixou cada braço e perna na pessoa certa no nosso golpe de judô e escreveu certo a placa e a legenda do nosso exemplo. Ele acrescenta cortes e música se você não pedir o contrário, e ignora algumas palavras de estilo, como o tipo de película (Fuser).
MiniMax H3 (o modelo do Hailuo AI) aparece aqui em duas versões. O H3 Max Turbo é o vídeo mais rápido e de menor preço da página, bom para testar o texto do prompt antes de gastar mais. O H3 padrão acrescenta 2K. Ele renderiza 768p como 1344×768, e não como 720p, e reescreve prompts curtos, o que pode acrescentar um corte (Krea).
Texto para vídeo ou imagem para vídeo?
O texto para vídeo inventa tudo a partir das suas palavras, então duas gerações com o mesmo prompt dão dois vídeos diferentes. Quando o produto, o personagem ou a composição precisam bater com algo que você já tem, comece por uma foto: o modo imagem para vídeo usa a sua imagem como quadro inicial. Um fluxo comum é criar a imagem no gerador de imagem com IA e depois animá-la.
Duração, resolução e formato
Escolha a menor duração que comporte a ação. Um vídeo de 5 segundos comporta um movimento; em 10 segundos cabem dois ou três momentos cronometrados; de 20 a 30 segundos servem para uma tomada única e longa no Kling 4.0 ou no Wan 3.0. A resolução é o que mais muda o preço, e gerar de novo em resolução maior cria uma tomada nova, não uma versão ampliada do seu rascunho; por isso, use 720p só para testar o texto do prompt. Escolha a proporção antes de gerar: 16:9 para YouTube e sites, 9:16 para celular, 1:1 para o feed, e 21:9 no Kling 4.0, no Seedance 2.5 e no MiniMax H3 para um quadro largo de cinema.
Quanto você paga
Cada vídeo tem um preço em créditos que depende do modelo, da duração, da resolução e do som, e você vê esse preço antes de gerar. Os créditos vêm de pacotes de pagamento único e não expiram, então não há plano mensal para cancelar. Se um vídeo falhar, exceder o tempo ou for recusado, os créditos voltam automaticamente para o seu saldo.
Como fizemos os exemplos desta página
Cada exemplo mostra o prompt, o modelo e as configurações usadas, além do preço dele hoje na zzo.ai. A maioria dos prompts vem de testes e guias publicados, com a fonte indicada em cada card, para você comparar o nosso resultado com o deles. Alguns exemplos foram feitos no app do próprio fabricante do modelo, com o mesmo modelo, prompt e configurações, e estão marcados assim. Nenhum vídeo foi editado, e quando um vídeo não seguiu parte do prompt, o card diz isso.